Den größten Teil des vergangenen Jahrzehnts lautete die Frage für ein Unternehmen, das neue Software einführte, welches Werkzeug es kaufen sollte. Mit KI ist daraus eine andere Frage geworden: wo die Berechnung laufen wird und zu welchem Preis. Ein Modell, das Verträge liest, eine Pipeline, die Tausende Fotografien in einen 3D-Zwilling verwandelt, ein Agent, der über Nacht einen Rückstand abarbeitet: Sie alle verbrauchen GPU-Zeit, Speicher und Energie, und dieser Verbrauch endet nicht nach dem Pilotprojekt.
Der Zugang zu Rechenleistung zu tragfähigen Kosten wird zur Grundvoraussetzung dafür, KI überhaupt einzusetzen. Organisationen, die ihn haben, können experimentieren, iterieren und Workloads in den Produktivbetrieb überführen. Diejenigen, die ihn nicht haben, bleiben bei der Demo stehen.
Was die Zahlen 2026 sagen
Der Markt sendet gemischte Signale, und beide Seiten sind von Bedeutung.
- Ältere GPUs werden günstiger, die neuesten nicht. Der AIMultiple Cloud GPU Price Index, der 75 Anbieter erfasst, beziffert den On-Demand-Median im September 2026 auf 3,25 $ pro Stunde für eine H100 und 4,40 $ für eine H200, während eine B200 bei 6,52 $ liegt. Der Median für die neueste Chipgeneration hat sich seit Oktober 2024 mehr als verdoppelt, von 2,12 $ auf 4,72 $ pro Stunde.
- Derselbe Chip kann je nach Verkäufer sechsmal so viel kosten. Im selben Index reicht der Preis für eine H200-Stunde von etwa 2 $ bis fast 14 $. Wo Sie kaufen, ist ebenso wichtig wie das, was Sie kaufen.
- Die Großen investieren in einem Umfang, den niemand sonst erreichen kann. Analystenauswertungen der Unternehmensprognosen beziffern die Investitionsausgaben von Amazon, Alphabet, Microsoft und Meta für 2026 auf zusammen über 700 Mrd. $. Der Großteil der neuesten Kapazität ist für sie und ihre größten Kunden reserviert.
- Strom ist der nächste Engpass. Die Internationale Energieagentur erwartet, dass sich der Stromverbrauch von Rechenzentren bis 2030 mehr als verdoppelt. Neue Kapazität wartet inzwischen auf Netzanschlüsse, nicht nur auf Chips.
- Der Preis pro Token sinkt weiter, die Rechnung nicht. Der Ramp AI Index meldet, dass der durchschnittliche Preis, den US-Unternehmen pro Million Token zahlen, zwischen März und September 2026 um 41 % gesunken ist. Die Nutzung wächst schneller, als die Preise fallen, vor allem sobald Agenten eigenständig mehrstufige Aufgaben ausführen.
Die Auswirkung zeigt sich bei der Verbreitung. Laut Eurostat nutzten 2025 55 % der großen Unternehmen in der EU KI, gegenüber 17 % der kleinen. Die Lücke hat nichts mit mangelndem Interesse zu tun. Es geht darum, wer sich die Infrastruktur, das Personal für ihren Betrieb und das Risiko der Datenübertragung leisten kann.
Drei Optionen, keine davon passt wirklich
Eine Organisation, die über große, wertvolle Datenbestände verfügt (Scans, Archive, Zeichnungen, Modelle, Forschungsdaten), steht in der Regel vor drei Möglichkeiten.
- Bei einem Hyperscaler mieten. Kapazität ist vorhanden, aber die Preisgestaltung ist auf Großkunden ausgerichtet, und die Daten müssen in die Infrastruktur eines Dritten verlagert werden, bevor die Arbeit beginnen kann.
- Die Hardware kaufen. Zwischen den Lastspitzen stehen die GPUs den größten Teil des Monats still, und jemand im eigenen Haus muss sie betreiben, aktualisieren und absichern.
- Die Daten an einen Dienstleister geben. Die Kontrolle ist weg. Sie entscheiden nicht mehr, wohin die Dateien gehen, und Sie zahlen für jeden Auftrag erneut.
Öffentliche Programme helfen am Rand. Die EuroHPC AI Factories bieten kostenlose Zugangsmodelle für KMU und Start-ups, und die Ausschreibung für AI Gigafactories endet am 12. November 2026. Sie sind wertvoll für Forschung und Modelltraining, werden aber über Anträge vergeben und sind nicht dafür ausgelegt, die täglichen Produktiv-Workloads eines Unternehmens zu betreiben.
DePIN: reichlich Kapazität, zu wenig Vertrauen
Dezentrale physische Infrastrukturnetzwerke (DePIN) gehen einen anderen Weg. Sie bündeln ungenutzte GPUs aus Rechenzentren, Unternehmen und von Privatpersonen und vermieten sie, oft deutlich unter den Preisen der Hyperscaler. Die Idee ist schlüssig: Ein großer Teil der weltweiten Rechenleistung bleibt den Großteil des Tages ungenutzt.
Die Probleme sind ebenso konkret, und sie sind durch unabhängige Forschung belegt:
- Angegebene Kapazität ist nicht tatsächliche Kapazität. Ein Knoten kann eine GPU anbieten, die er nicht hat, oder eine, die geteilt, gedrosselt oder mit dem Auftrag inkompatibel ist.
- Die Verfügbarkeit schwankt. Knoten kommen und gehen. Ein langer Rendering- oder Trainingsauftrag benötigt Checkpoints und einen Ort, an dem er fortgesetzt werden kann, wenn ein Knoten verschwindet.
- Der Standort ist unbekannt. Für viele Datenbestände ist eine Verarbeitung „irgendwo im Netzwerk“ schlicht nicht zulässig.
- Ergebnisse sind schwer zu überprüfen. Nachzuweisen, dass eine Berechnung auf einer nicht vertrauenswürdigen Maschine korrekt ausgeführt wurde, ist nach wie vor ein offenes Forschungsproblem.
Günstige Kapazität, der man nicht vertrauen kann, ist für wichtige Daten nicht nutzbar. Die Frage ist nicht, ob verteilte Kapazität günstiger ist. Die Frage ist, ob sie sich steuern lässt.
Sie haben einen rechenintensiven Workload und keinen sinnvollen Ort, ihn auszuführen? Erzählen Sie uns von den Daten und den Rahmenbedingungen. Sprechen Sie mit dem TrustTwin OS-Team.
Wie der Smart Compute Router und DePIN-Knoten in TrustTwin OS zusammenwirken
TrustTwin OS behandelt Rechenleistung als ein einziges Ausführungskontinuum. Aufgaben können auf unseren eigenen verwalteten Knoten laufen, auf Knoten, die auf der Hardware des Kunden installiert sind, oder auf ungenutzter Kapazität, die Kunden und Partner dem Netzwerk zur Verfügung stellen, einschließlich DePIN-Kapazität. Was sich ändert, ist nicht der Standort der GPUs. Entscheidend ist, dass jeder Auftrag vor, während und nach der Ausführung dieselbe Governance durchläuft.
Der Smart Compute Router führt jeden Workload durch sechs Stufen:
- Classify. Um welche Art von Arbeit es sich handelt und wie sensibel die Daten sind.
- Constrain. Data-Residency- und Sicherheitsrichtlinien werden als harte Grenzen angewendet. Ein reines EU-Profil schließt außereuropäische Anbieter vollständig aus. Kann eine Residency-Regel nicht garantiert werden, wird der Workload nicht ausgeführt.
- Preflight. GPU, VRAM, CUDA, Netzwerk und eine minimale Ausführung werden auf dem Kandidatenknoten überprüft, bevor der Auftrag vergeben wird. Angegebene Kapazität wird geprüft, nicht vorausgesetzt.
- Route. Kosten, Zeit und Risiko werden über lokale, Cloud-, Edge- und verteilte Kapazität hinweg optimiert, unter den Knoten, die die ersten drei Stufen bestanden haben.
- Recover. Wiederholungsversuche, Checkpoints und Ausweichen auf einen anderen Knoten, wenn ein Anbieter ausfällt.
- Validate. Vollständigkeit und Qualität der Ergebnisse werden geprüft, mit einem Nachweis darüber, wo jeder Schritt lief und welche Entscheidungen getroffen wurden.
Genau das macht DePIN-Kapazität für ernsthafte Arbeit nutzbar. Preflight löst das Problem der Kapazität, die nur auf dem Papier existiert. Recover löst das Problem ausfallender Knoten. Constrain löst die Standortfrage. Validate beantwortet die Frage, ob dem Ergebnis vertraut werden kann. Der Router unterstellt verteilter Rechenleistung keine Vertrauenswürdigkeit; er nutzt sie nur dort, wo die Prüfungen bestanden werden.
Warum die Kosten mit der Zeit sinken
Die Wirtschaftlichkeit ergibt sich aus der Architektur. Rechenintensive Verarbeitung läuft unbeaufsichtigt auf unseren eigenen und auf Partnerknoten, zu einem Bruchteil der Hyperscaler-Kosten. Kunden können ihre eigene Rechenkapazität dem Netzwerk zur Verfügung stellen, wenn sie sie nicht benötigen, sodass eine Workstation, die nachts ungenutzt bliebe, Kapazität beisteuert, statt nur an Wert zu verlieren. Je mehr Knoten sich unter denselben Richtlinien anschließen, desto stärker sinken die Stückkosten für alle im Netzwerk.
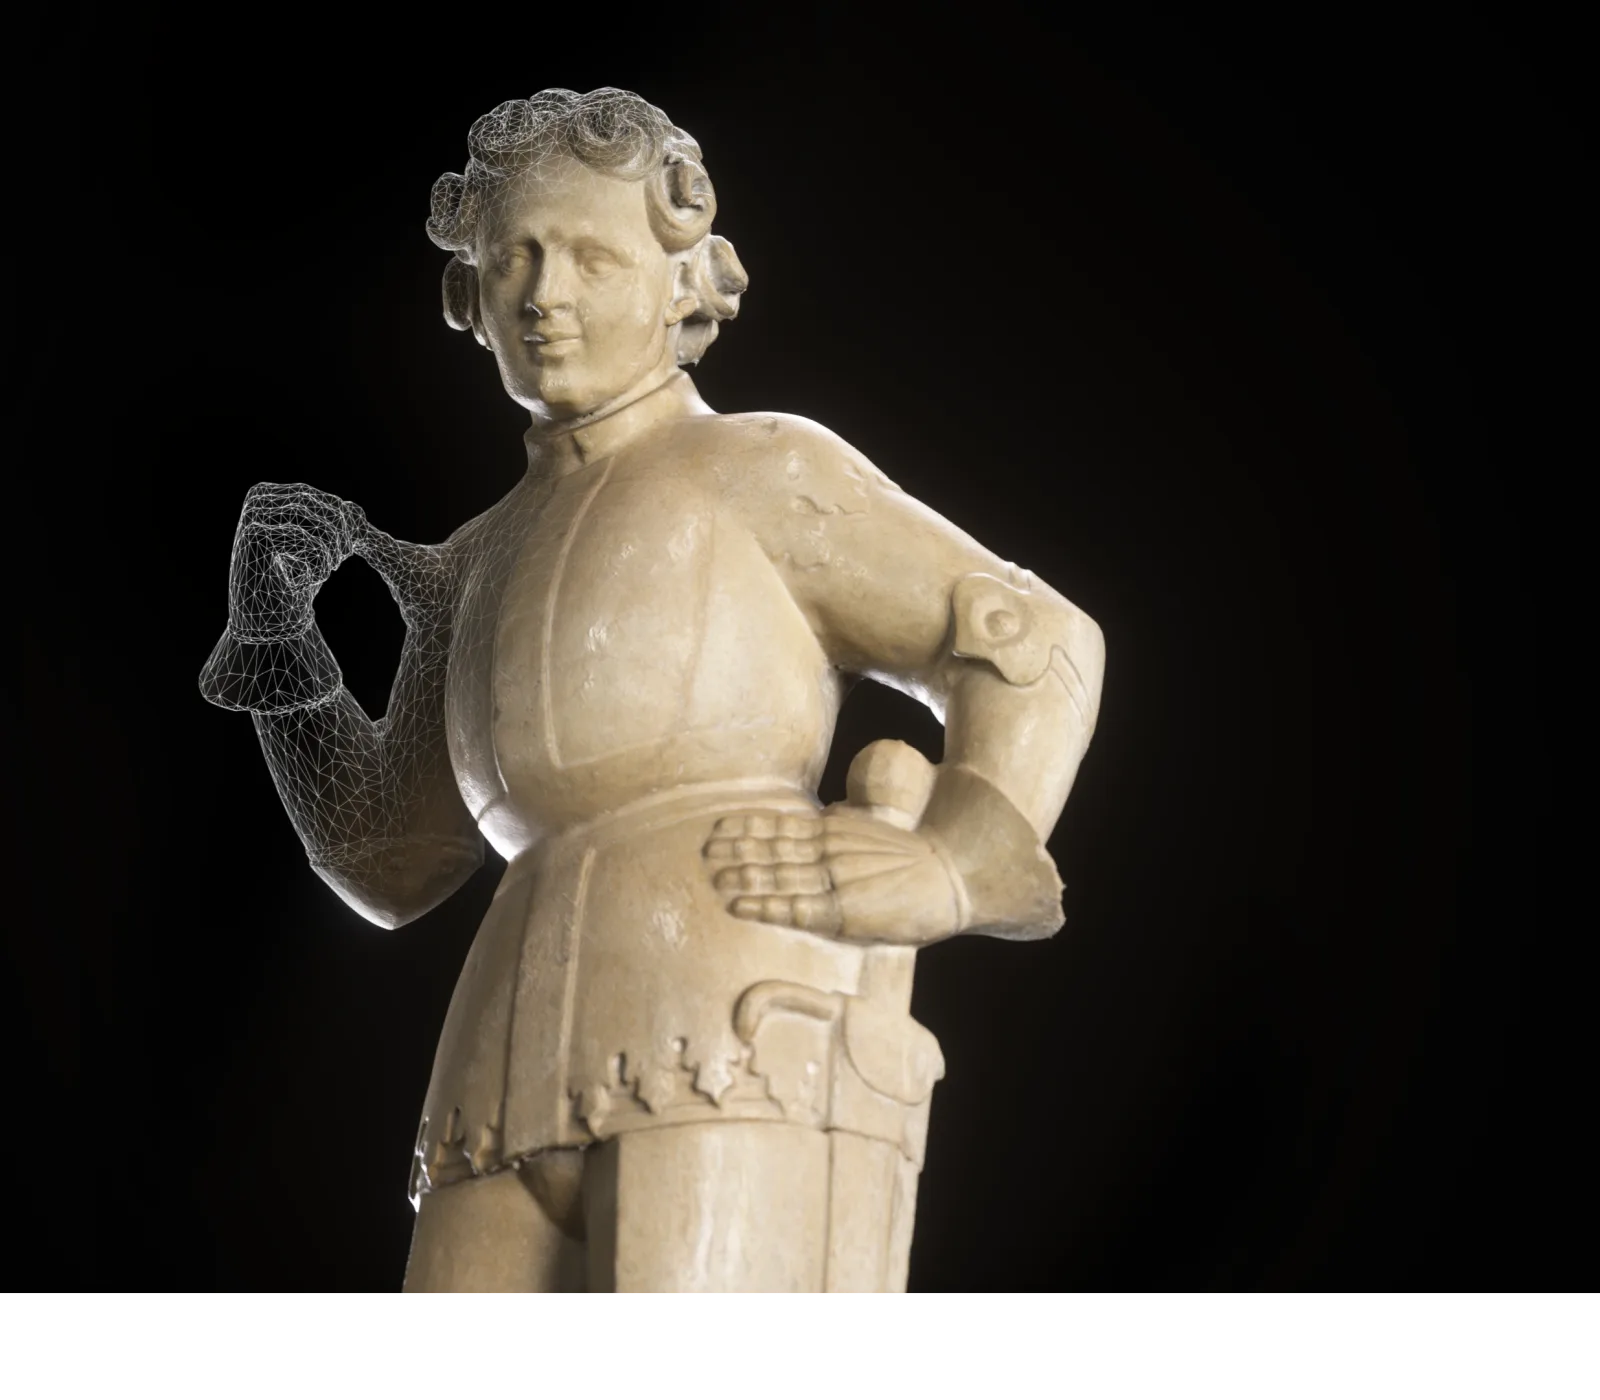
Wir haben dies dort erprobt, wo die Daten am anspruchsvollsten sind. In AerariumChain werden Scans unersetzlicher Objekte auf privaten und Partnerknoten verarbeitet, unter strengen Regeln dazu, wohin die Daten gelangen dürfen. SweetHive bringt dasselbe OS zu kleinen und mittleren Unternehmen, mit lokalen Knoten, die Dateien und Modelle auf den Rechnern des Unternehmens belassen.
Fünf Fragen an jeden Anbieter von Rechenleistung
- Können Sie garantieren, wo meine Daten verarbeitet werden, und was geschieht, wenn Sie es nicht können?
- Überprüfen Sie die tatsächliche Kapazität einer Maschine, bevor mein Auftrag startet?
- Was passiert mit einem langen Auftrag, wenn ein Knoten auf halber Strecke ausfällt?
- Wie prüfen Sie, ob das Ergebnis vollständig und korrekt ist?
- Kann ich im Nachhinein einsehen, wo jeder Schritt lief?
Wenn die Antworten vage ausfallen, ist der niedrige Preis nicht der ganze Preis.
Quellen
- AIMultiple, Cloud GPU Price Index, Daten bis September 2026: aimultiple.com/gpu-index
- Ramp, AI Index, 9. September 2026: ramp.com/data/ai-index-sept-2026
- TMT Finance, Analyse der Hyperscaler-Investitionen 2026: tmtfinance.com
- Internationale Energieagentur, Energy and AI: iea.org/reports/energy-and-ai
- Eurostat, Digital economy and society statistics, enterprises: ec.europa.eu/eurostat
- EuroHPC JU, Zugangsmodelle der AI Factories und Ausschreibung für AI Gigafactories, 30. Juli 2026: eurohpc-ju.europa.eu
- Forschung zur Verifikation in dezentralen GPU-Netzwerken: arXiv 2501.05374