Gesteuertes Compute für große, wertvolle Datensätze.
Private KI, 3D und schwere Verarbeitung auf Ihren Nodes, nach Ihren Richtlinien. Die Daten bleiben, wo sie hingehören, und die Arbeit wandert zu der Maschine, die sie ausführen darf. Bereits im Produktivbetrieb in AerariumChain und SweetHive.
In Europa gebaut. Global einsetzbar.
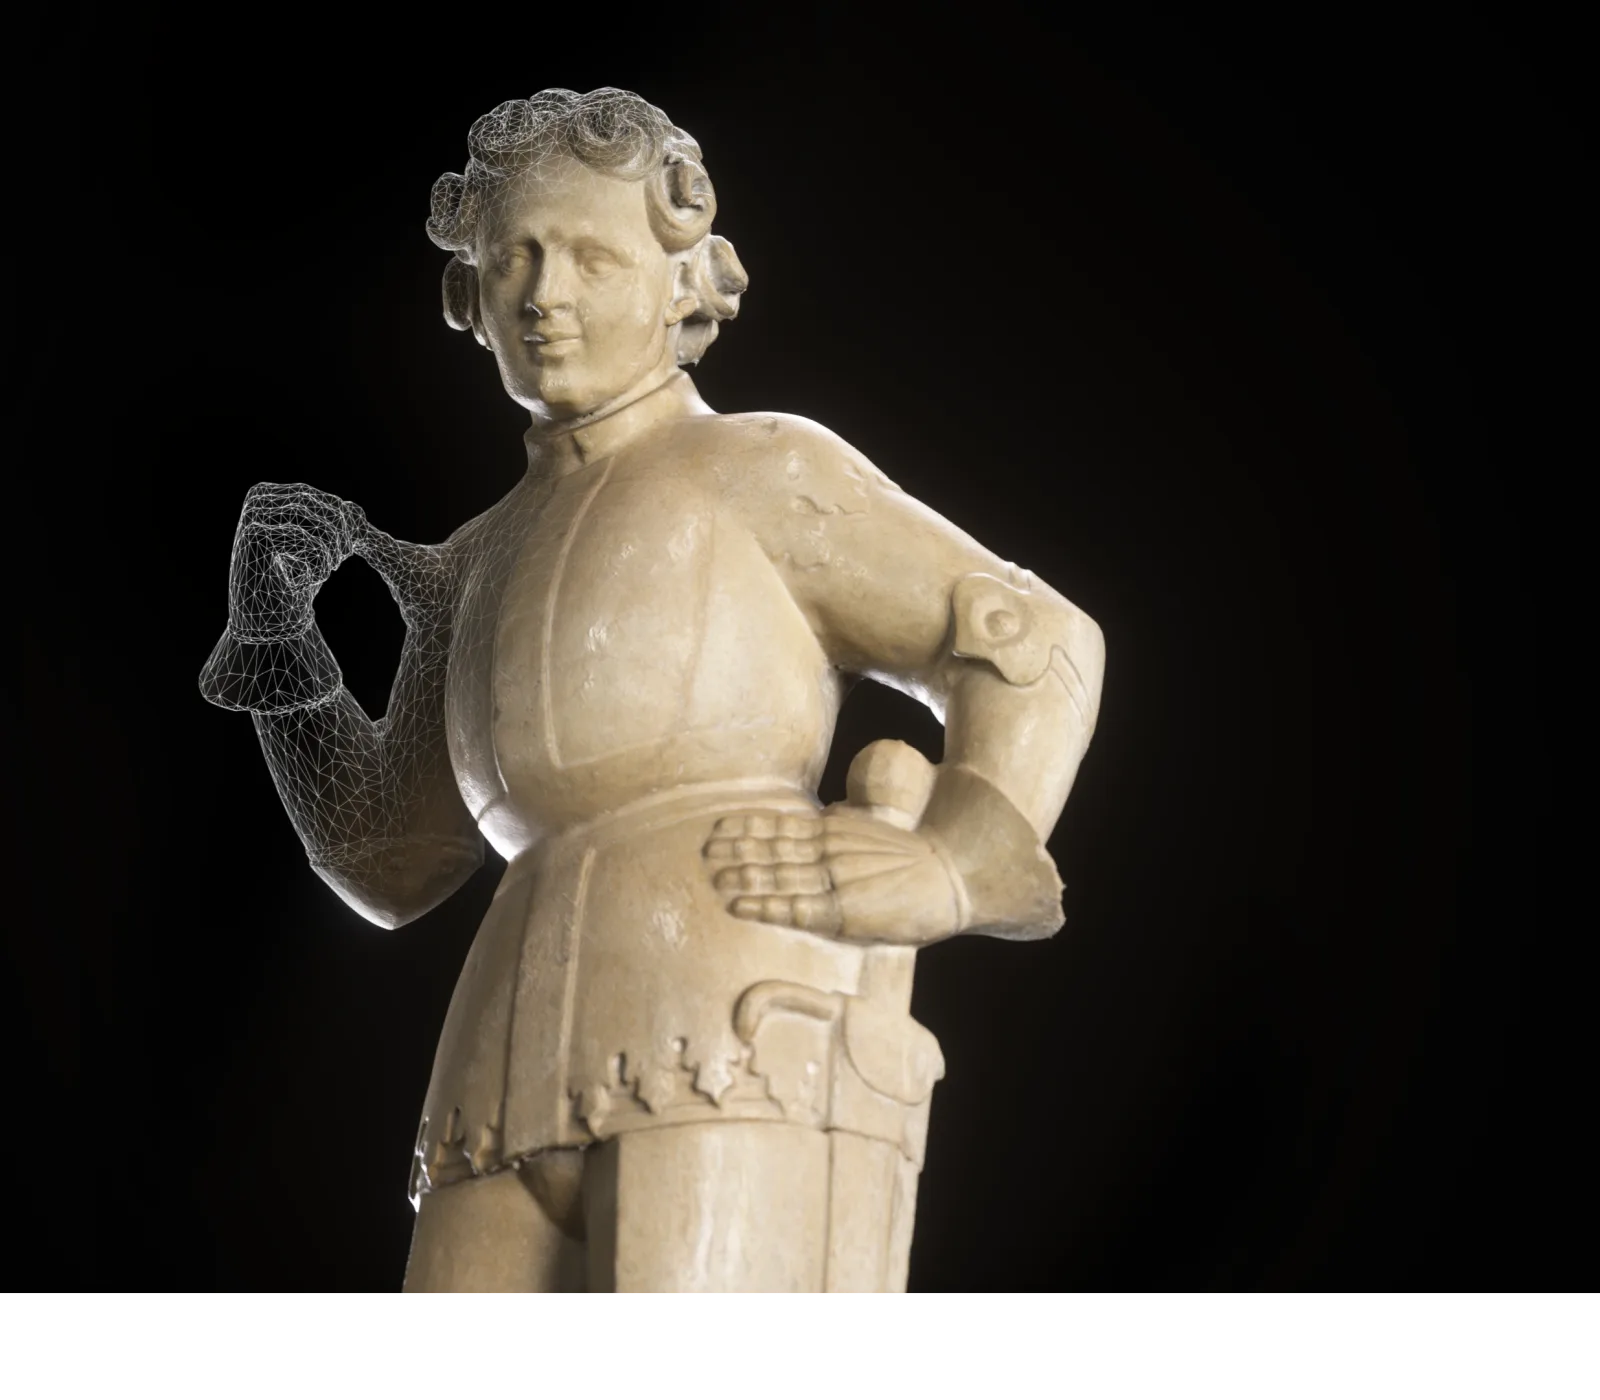
3D-Render-Output · AerariumChain-Produktionspipeline
KI und schweres Compute sind für die Giganten gebaut.
Organisationen mit großen, wertvollen Datensätzen haben heute drei Optionen, und keine passt. Wer betreibt private KI und schweres Compute für alle anderen?
Einen Hyperscaler mieten
Preise für Großkonzerne.
Die Preise sind auf Großkunden ausgelegt, und die Daten müssen erst in die Infrastruktur eines anderen wandern, bevor die Arbeit beginnen kann.
Die Hardware kaufen
Den größten Teil des Monats ungenutzt.
GPUs und Server stehen zwischen den Spitzen still, und im Haus ist niemand, der sie betreibt, aktualisiert und absichert.
Die Daten nach außen geben
Die Kontrolle ist weg.
Sobald Scans, Archive oder Modelle das Haus verlassen, entscheiden Sie nicht mehr, wohin sie gehen, und Sie zahlen für jeden Job erneut.
Eine wiederholbare Pipeline, von der lokalen Erfassung bis zu den Werkzeugen.
Die Daten bleiben, wo sie hingehören. Die Arbeit wandert zu der Maschine, die sie ausführen darf.
-
01
Lokale Erfassung
Wo die Daten entstehen: Scanner, Firmenrechner, Archive, lokale Modelle.
-
02
Hochladen
Nur, was sich bewegen muss, und nur, was die Richtlinie erlaubt.
-
03
Verteilte Verarbeitung
Unbeaufsichtigt, auf vom Router gewählten Nodes.
-
04
Hochladen
Validierte Ergebnisse, mit einem Nachweis, wo sie gelaufen sind.
-
05
Werkzeuge
Hubs, Viewer, Apps und Agenten, auf jedem Gerät.
Durchgängig gesteuertBerechtigungenResidencyKapazitätKosten
Dieselben fünf Schritte betreiben heute ein Museum und ein kleines Unternehmen.
Von Ihren Nodes ins Netzwerk.
Ein Ausführungskontinuum, gesteuert vom Router: Die Arbeit läuft auf unseren Nodes, auf Nodes auf Ihrer eigenen Hardware oder auf ungenutzter Kapazität, die Kunden und Partner dem Netzwerk zur Verfügung stellen, immer unter denselben Richtlinien.
Was der Router möglich macht.
Vier Fähigkeiten, dieselben für ein Museum und für ein kleines Unternehmen.
Schwere Verarbeitung zu einem Bruchteil der Kosten
Unbeaufsichtigt, auf eigenen und Partner-Nodes, zu einem Bruchteil der Hyperscaler-Kosten. Kunden können ihre Rechenkapazität dem Netzwerk zur Verfügung stellen, wenn sie sie nicht brauchen, und die Stückkosten sinken, während das Netzwerk wächst.
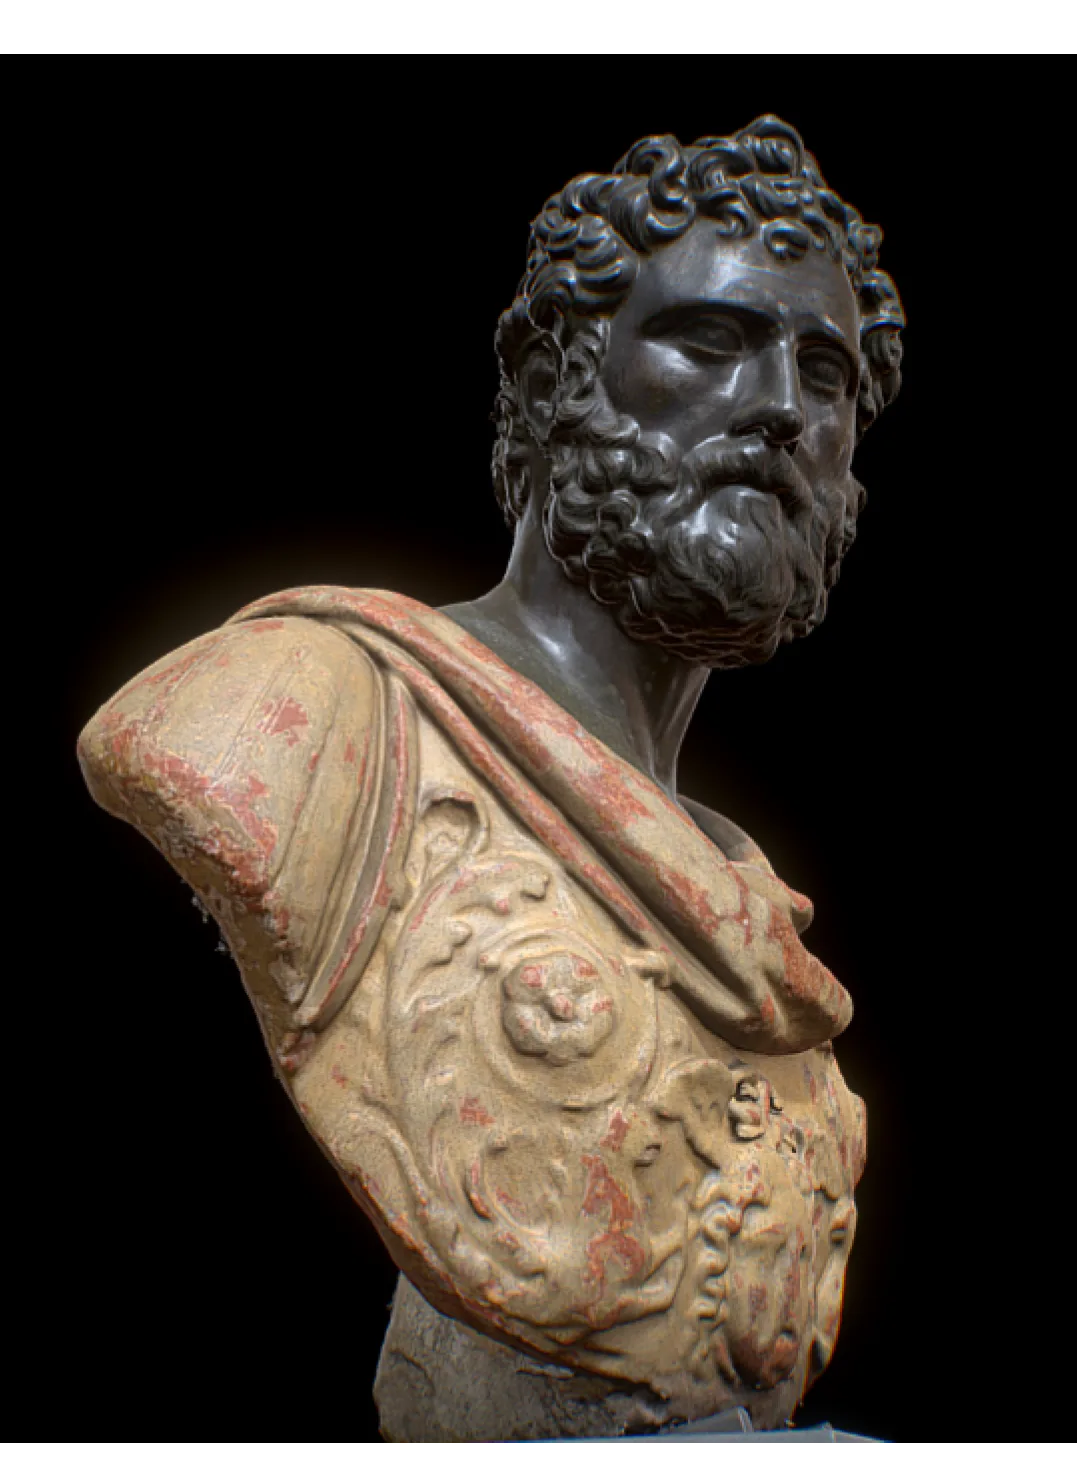
Komplexe Workflows auf lokalen Nodes
Jeder Verarbeitungs-Workflow, auch ein komplexer, lässt sich über den Job-Scheduler schnell im Node-Netzwerk einrichten. Für jeden Schritt wählt der Router die Maschine, die ihn ausführen darf, prüft, ob ihre Kapazität real ist, fängt Ausfälle ab und validiert das Ergebnis.
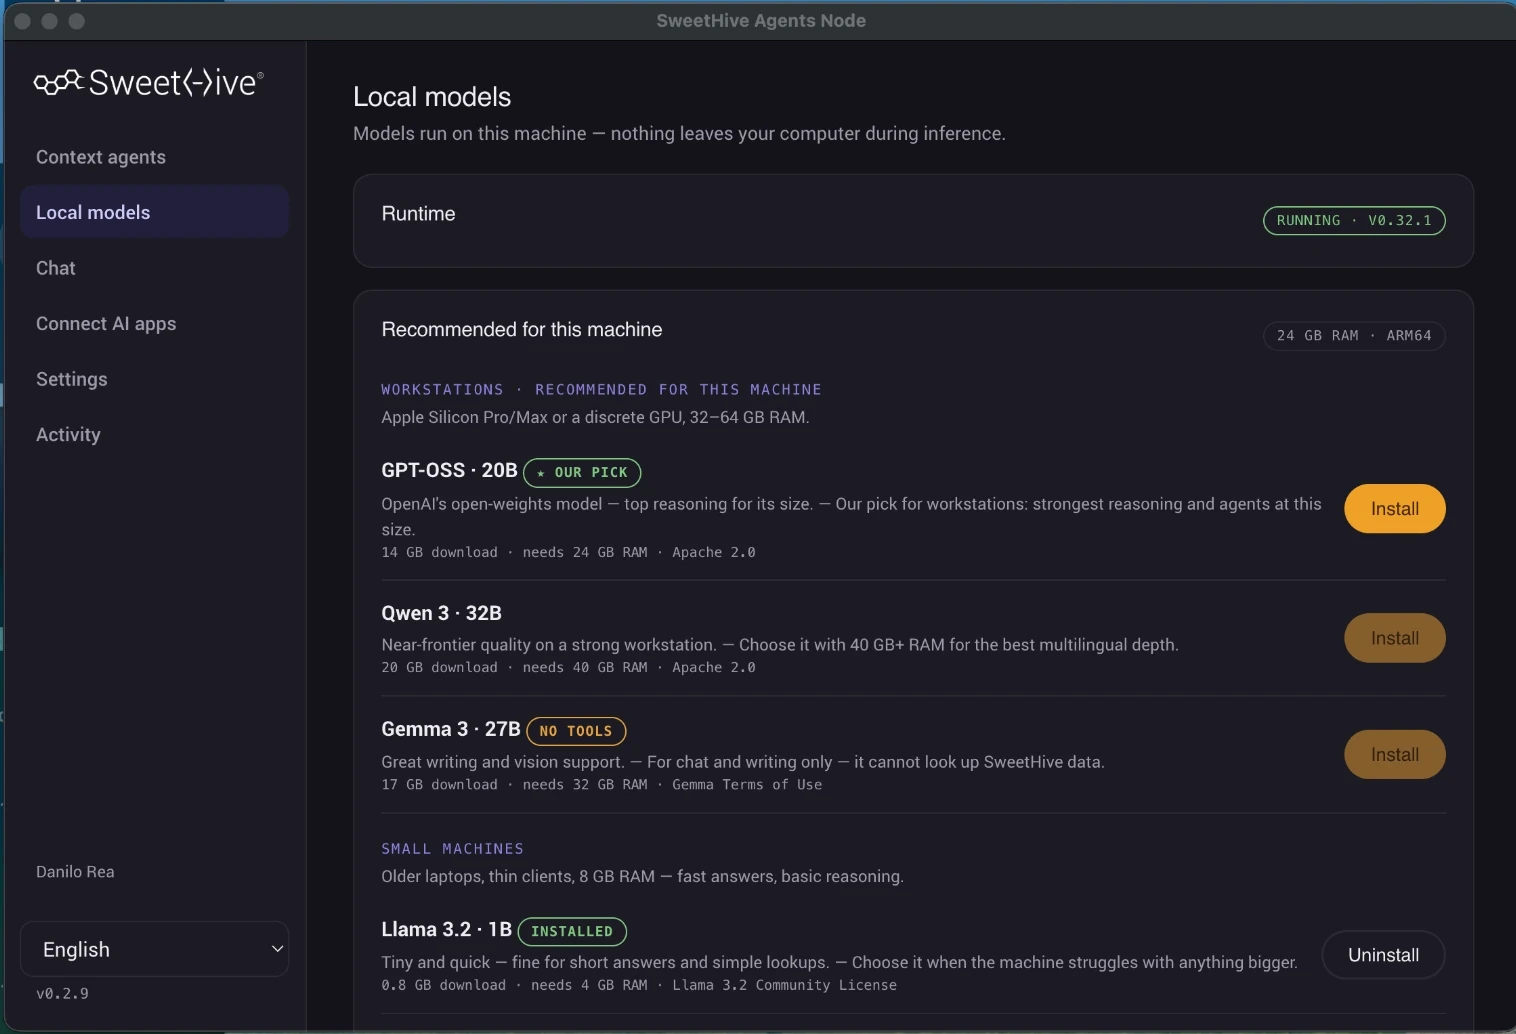
Lokale KI, einfach verwaltet
Die Modelle laufen auf Ihren lokalen Nodes, und wir halten sie aktuell. Private Agenten wissen nur, was Ihre Teams erlauben, und nichts verlässt das Haus ohne Richtlinie.
Werkzeuge und Echtzeitzugriff auf jedem Gerät
Schwere Daten werden von entfernten Nodes auf Hubs, Viewer und Apps auf jedem Gerät gestreamt, ohne dass die Quelldaten je auf Nutzergeräte kopiert werden.
Bewährt, wo Daten am schwierigsten sind.
Wir haben TrustTwin OS nicht im Labor validiert. Wir haben es in Europas Museen validiert: schwere 3D-Daten, unersetzliche Objekte, strenge Regeln dafür, wohin Daten dürfen.
Ein Umfeld, in dem Fehler teuer sind und Daten sich nicht einfach verschieben oder neu erzeugen lassen. Deshalb kam AerariumChain zuerst. SweetHive bringt dasselbe OS jetzt zu kleinen und mittleren Unternehmen.
TrustTwin OS Core.
In den kommenden Jahren wird das OS selbst zum Produkt: als White Label für Partner oder als Kerninfrastruktur, die Unternehmen auf ihren eigenen Nodes betreiben. Heute bauen wir es mit Partnern und ersten Design-Partnern.
Wo sich dasselbe Muster wiederholt
Große Dateien, private Datensätze, Zusammenarbeit mit Partnern, GPU-Spitzen, kontrolliertes Hosting, Audit-Pflichten.
Kontrolle ist Teil der Architektur.
Data Residency wird durchgesetzt, nicht versprochen. Konfigurieren Sie lokale, private, EU-only oder länderspezifische Verarbeitung, mit EU-only-Profilen, die außereuropäische Anbieter vollständig ausschließen.
Wo Daten liegen.
Wo Workloads laufen.
Wo Inferenz stattfindet.
Kann eine Residency-Regel nicht garantiert werden, läuft der Workload nicht.
Besonders wertvoll für europäische Deployments. Das zugrunde liegende Kontrollmodell ist global relevant.
Eine Architektur. Von privater KI bis zu den schwersten Digital Twins.
Für Partner, Pilotprojekte und erste Design-Partner: Erzählen Sie uns von Ihren Daten und Workloads, und wir zeigen Ihnen, wie TrustTwin OS sie auf Ihren Nodes nach Ihren Richtlinien ausführt.