Compute gobernado para datasets grandes y valiosos.
IA privada, 3D y procesamiento pesado en sus nodos, según sus políticas. Los datos se quedan donde deben estar, y el trabajo va a la máquina autorizada para ejecutarlo. Ya en producción en AerariumChain y SweetHive.
Construido en Europa. Desplegable globalmente.
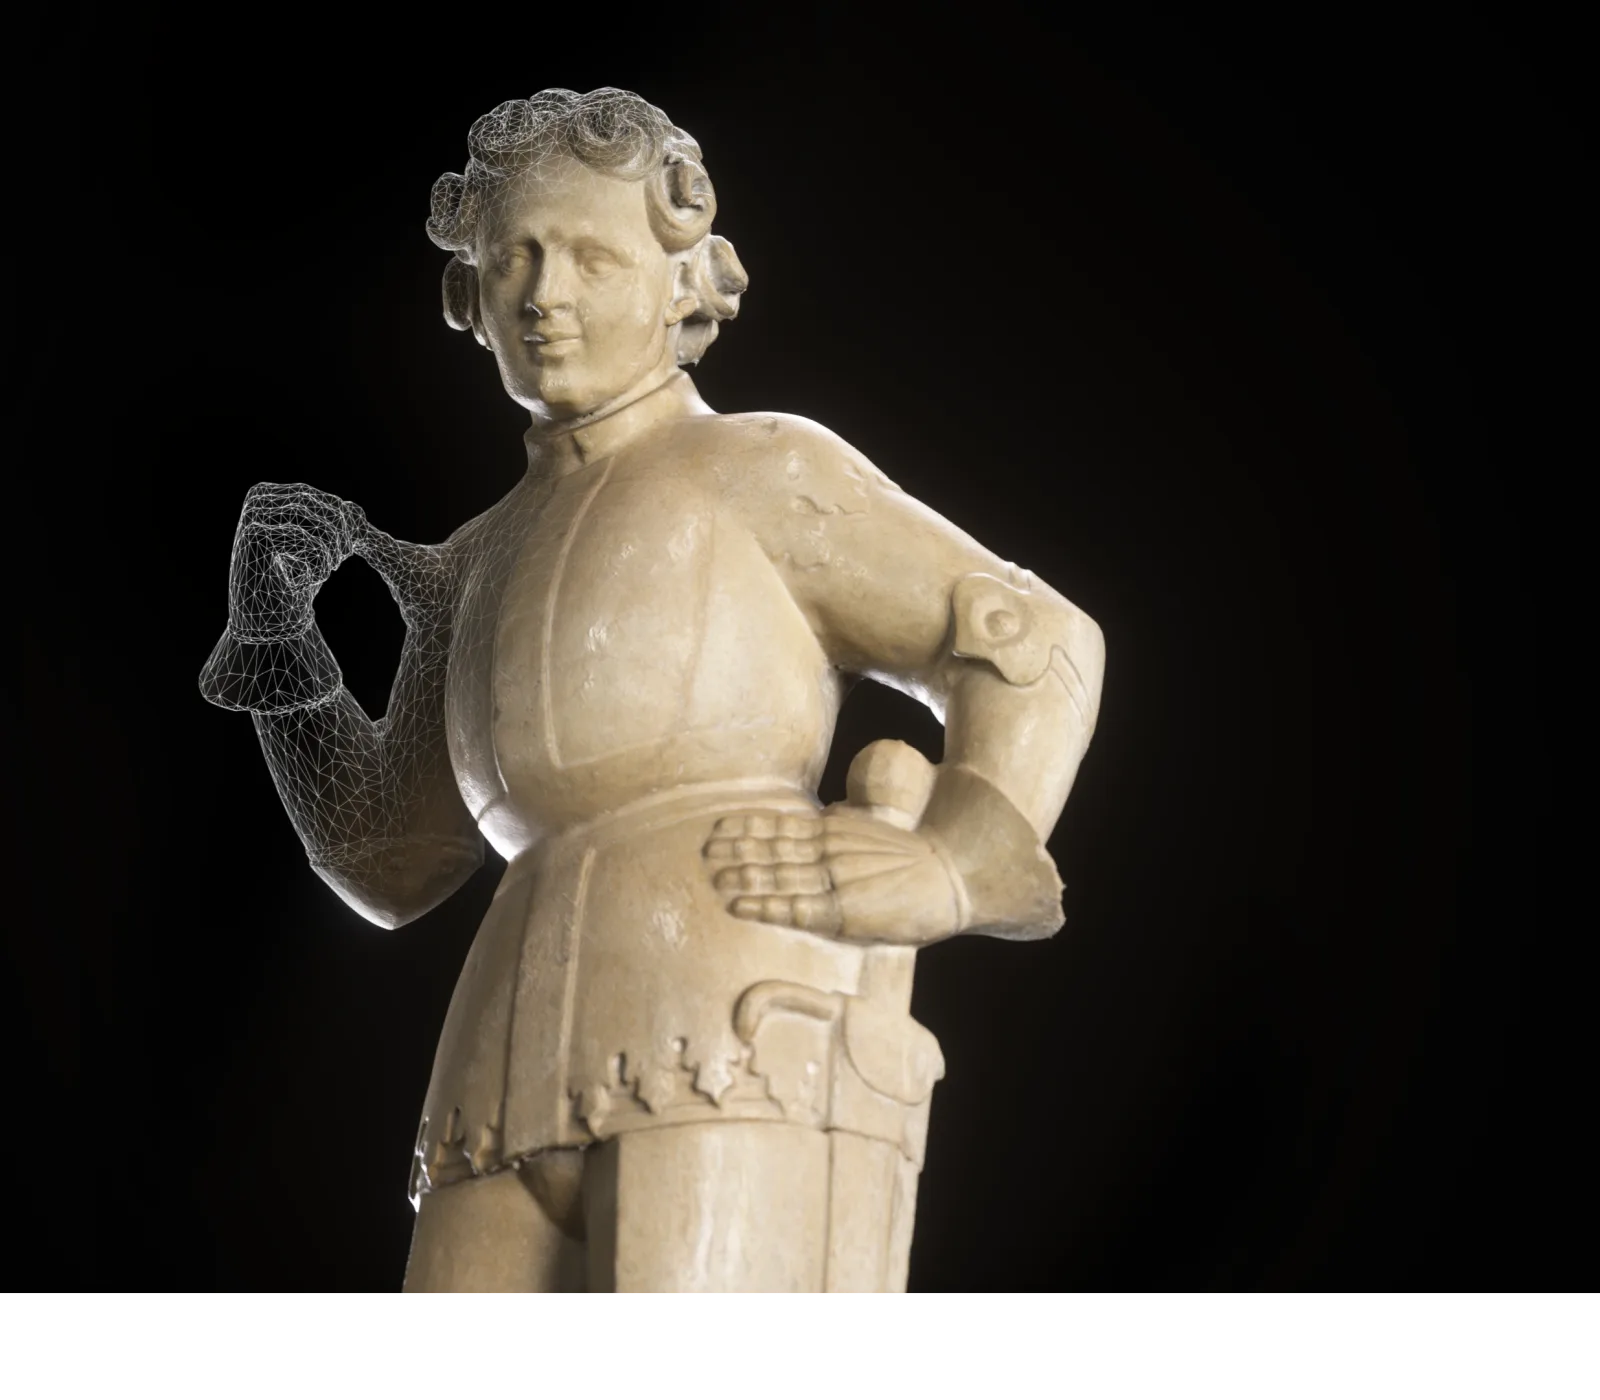
Salida de render 3D · pipeline de producción de AerariumChain
La IA y la computación pesada están hechas para los gigantes.
Las organizaciones con datasets grandes y valiosos tienen hoy tres opciones, y ninguna encaja. ¿Quién ejecuta la IA privada y la computación pesada para todos los demás?
Alquilar un hyperscaler
Precios de gran empresa.
Los precios están pensados para grandes cuentas, y los datos tienen que trasladarse a la infraestructura de otro antes de que pueda empezar el trabajo.
Comprar el hardware
Parado casi todo el mes.
Las GPU y los servidores quedan sin uso entre picos, y no hay nadie en casa para operarlos, actualizarlos y protegerlos.
Enviar los datos fuera
Se pierde el control.
Una vez que los escaneos, archivos o modelos salen, ya no decide adónde van, y paga de nuevo por cada trabajo.
Una única pipeline repetible, de la adquisición local a las herramientas.
Los datos se quedan donde deben estar. El trabajo va a la máquina autorizada para ejecutarlo.
-
01
Adquisición local
Donde nacen los datos: escáneres, equipos de la empresa, archivos, modelos locales.
-
02
Subida
Solo lo que debe moverse, y solo lo que la política permite.
-
03
Procesamiento distribuido
Desatendido, en nodos elegidos por el router.
-
04
Subida
Resultados validados, con registro de dónde se ejecutaron.
-
05
Herramientas
Hubs, visores, apps y agentes, en cualquier dispositivo.
Gobernado de principio a finPermisosResidenciaCapacidadCoste
Los mismos cinco pasos hacen funcionar hoy un museo y una pequeña empresa.
De sus nodos a la red.
Un único continuum de ejecución gobernado por el router: el trabajo se ejecuta en nuestros nodos, en nodos instalados en su propio hardware o en la capacidad ociosa que clientes y socios ponen a disposición de la red, siempre con las mismas políticas.
Lo que el router hace posible.
Cuatro capacidades, las mismas para un museo y para una pequeña empresa.
Procesamiento pesado a una fracción del coste
Desatendido, en nuestros nodos y en los de socios, a una fracción del coste de un hyperscaler. Los clientes pueden poner su capacidad de cálculo a disposición de la red cuando no la necesitan, y el coste unitario baja a medida que la red crece.
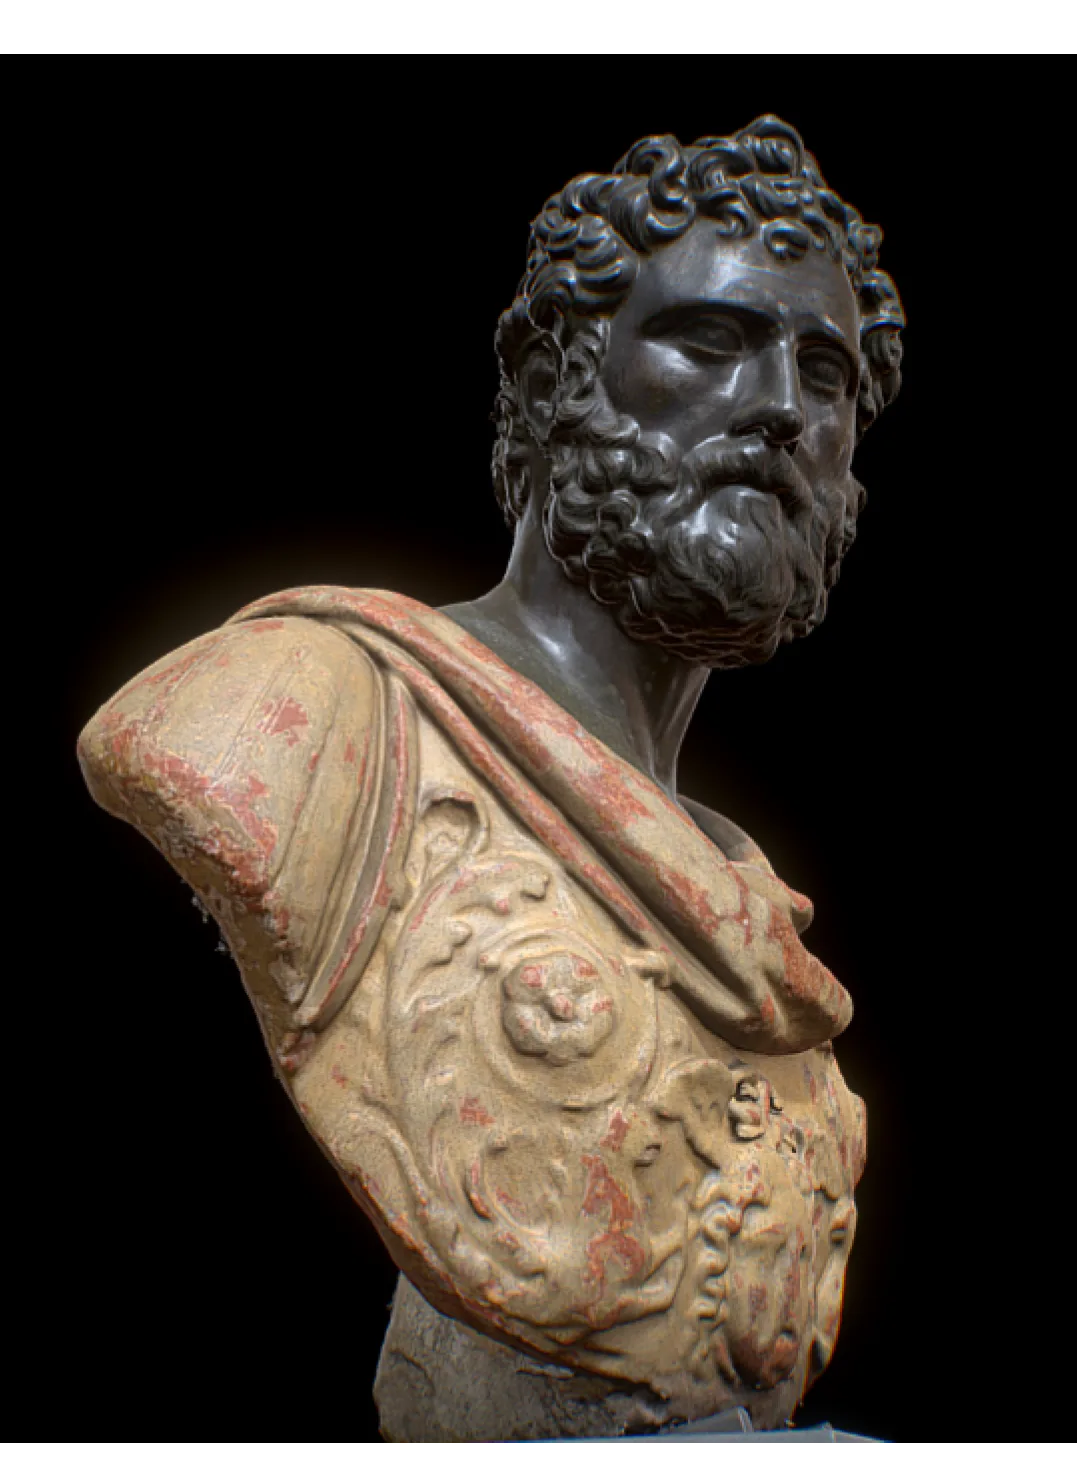
Workflows complejos en nodos locales
Cualquier workflow de procesamiento, incluso complejo, se configura rápidamente en la red de nodos mediante el job scheduler. Para cada paso, el router elige la máquina autorizada para ejecutarlo, comprueba que su capacidad es real, se recupera de los fallos y valida el resultado.
IA local, fácil de gestionar
Los modelos se ejecutan en sus nodos locales y nosotros los mantenemos actualizados. Los agentes privados solo saben lo que sus equipos permiten, y nada sale sin una política.
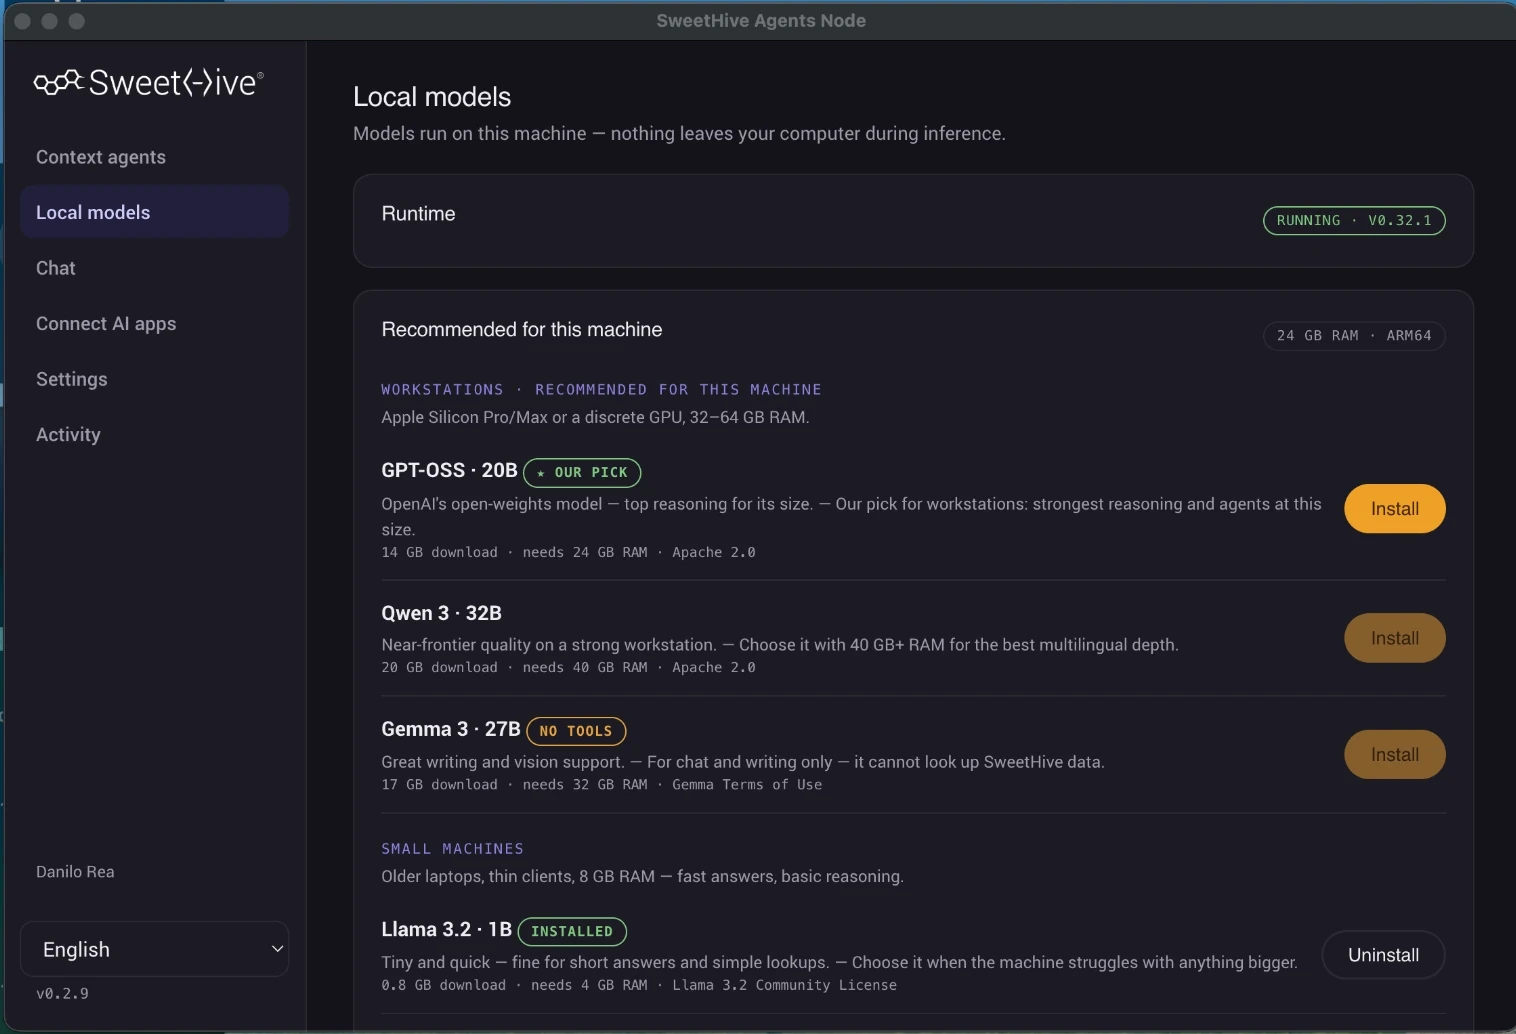
Herramientas y acceso en tiempo real desde cualquier dispositivo
Datos pesados transmitidos desde nodos remotos a hubs, visores y apps en cualquier dispositivo, sin que los datos de origen se copien nunca en los dispositivos de los usuarios.
Probado donde los datos son más difíciles.
No validamos TrustTwin OS en un laboratorio. Lo validamos en los museos europeos: datos 3D pesados, objetos insustituibles, reglas estrictas sobre adónde pueden ir los datos.
Un entorno donde los fallos cuestan caro y los datos no pueden simplemente moverse ni recrearse. Por eso AerariumChain llegó primero. Ahora SweetHive lleva el mismo OS a las pequeñas y medianas empresas.
TrustTwin OS Core.
En los próximos años el propio OS se convierte en el producto: en marca blanca para socios, o como infraestructura central que las empresas ejecutan en sus propios nodos. Hoy lo estamos construyendo con socios y primeros design partners.
Donde se repite el mismo patrón
Archivos grandes, datasets privados, colaboración con socios, picos de GPU, hosting controlado, obligaciones de auditoría.
El control es parte de la arquitectura.
La data residency se impone, no se promete. Configure procesamiento local, privado, solo UE o específico por país, con perfiles solo UE que excluyen por completo a los proveedores no europeos.
Dónde viven los datos.
Dónde se ejecutan los workloads.
Dónde ocurre la inferencia.
Si una regla de residencia no puede garantizarse, el workload no se ejecuta.
Especialmente valioso para despliegues europeos. El modelo de control subyacente es relevante a escala global.
Una sola arquitectura. De la IA privada a los digital twins más pesados.
Para socios, pilotos y primeros design partners: cuéntenos sus datos y sus workloads, y le mostraremos cómo TrustTwin OS los ejecuta en sus nodos, según sus políticas.