Compute governato per dataset grandi e di valore.
AI privata, 3D ed elaborazioni pesanti sui vostri nodi, secondo le vostre policy. I dati restano dove devono stare, e il lavoro si sposta sulla macchina autorizzata a eseguirlo. Già in produzione in AerariumChain e SweetHive.
Costruito in Europa. Deployabile globalmente.
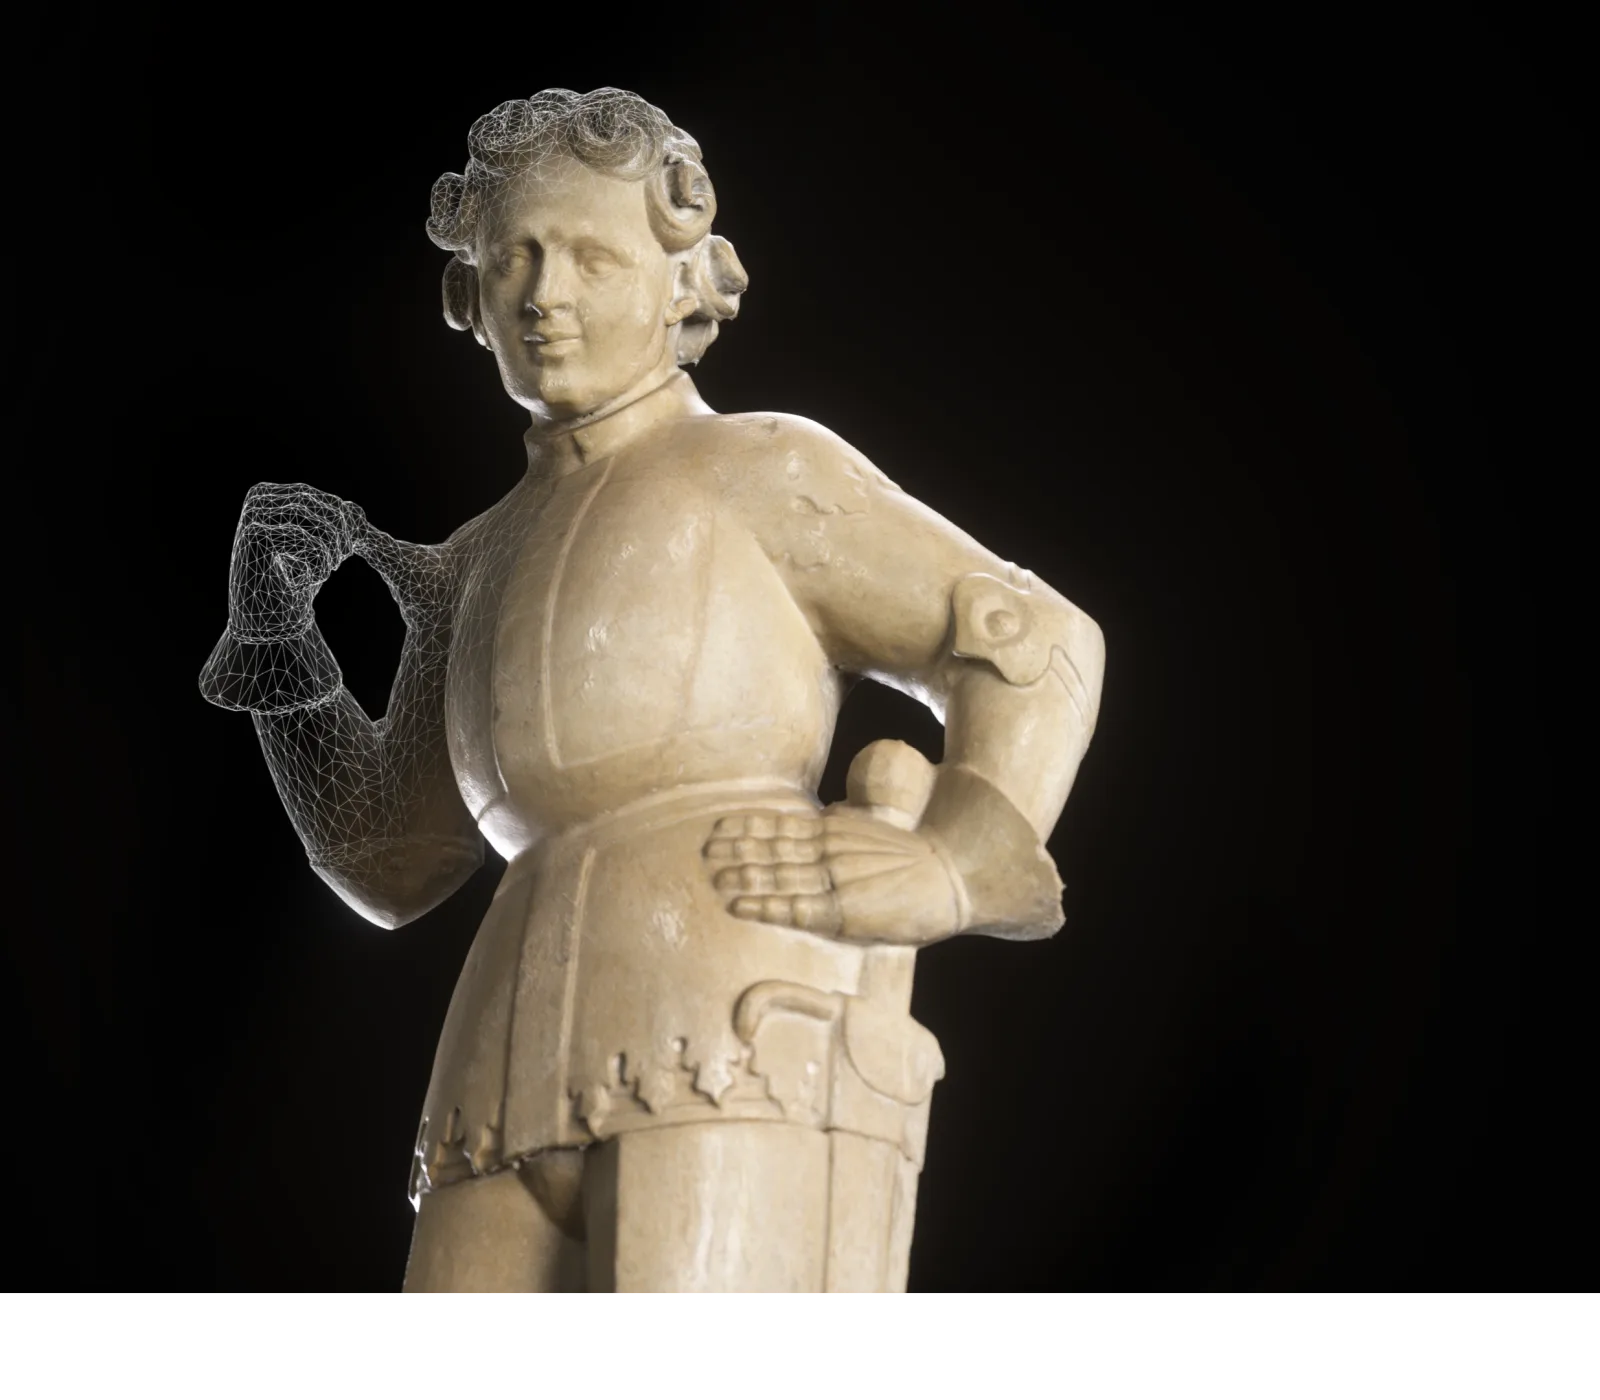
Output di render 3D · pipeline di produzione AerariumChain
L'AI e il calcolo pesante sono fatti per i giganti.
Chi possiede dataset grandi e di valore oggi ha tre opzioni, e nessuna funziona. Chi gestisce AI privata e calcolo pesante per tutti gli altri?
Affittare un hyperscaler
Prezzi da grande impresa.
I prezzi sono pensati per i grandi clienti, e i dati devono trasferirsi sull'infrastruttura di qualcun altro prima che il lavoro possa iniziare.
Comprare l'hardware
Fermo quasi tutto il mese.
GPU e server restano inutilizzati tra un picco e l'altro, e in casa non c'è nessuno che li gestisca, li aggiorni e li protegga.
Mandare fuori i dati
Il controllo è perso.
Quando scansioni, archivi o modelli escono, non decidete più dove vanno, e pagate di nuovo per ogni lavorazione.
Un'unica pipeline ripetibile, dall'acquisizione locale agli strumenti.
I dati restano dove devono stare. Il lavoro va sulla macchina autorizzata a eseguirlo.
-
01
Acquisizione locale
Dove nascono i dati: scanner, macchine aziendali, archivi, modelli locali.
-
02
Caricamento
Solo ciò che deve spostarsi, e solo ciò che la policy consente.
-
03
Elaborazione distribuita
Senza presidio, sui nodi scelti dal router.
-
04
Caricamento
Risultati validati, con traccia di dove sono stati eseguiti.
-
05
Strumenti
Hub, viewer, app e agenti, su qualsiasi dispositivo.
Governato dall'inizio alla finePermessiResidenzaCapacitàCosto
Gli stessi cinque passi fanno funzionare oggi un museo e una piccola azienda.
Dai vostri nodi alla rete.
Un unico continuum di esecuzione governato dal router: il lavoro gira sui nostri nodi, su nodi installati sul vostro hardware o sulla capacità inattiva che clienti e partner mettono a disposizione della rete, sempre con le stesse policy.
Cosa rende possibile il router.
Quattro capacità, le stesse per un museo e per una piccola azienda.
Elaborazioni pesanti a una frazione del costo
Senza presidio, sui nostri nodi e su quelli dei partner, a una frazione del costo di un hyperscaler. I clienti possono mettere a disposizione della rete la propria capacità di calcolo quando non la usano, e il costo unitario scende man mano che la rete cresce.
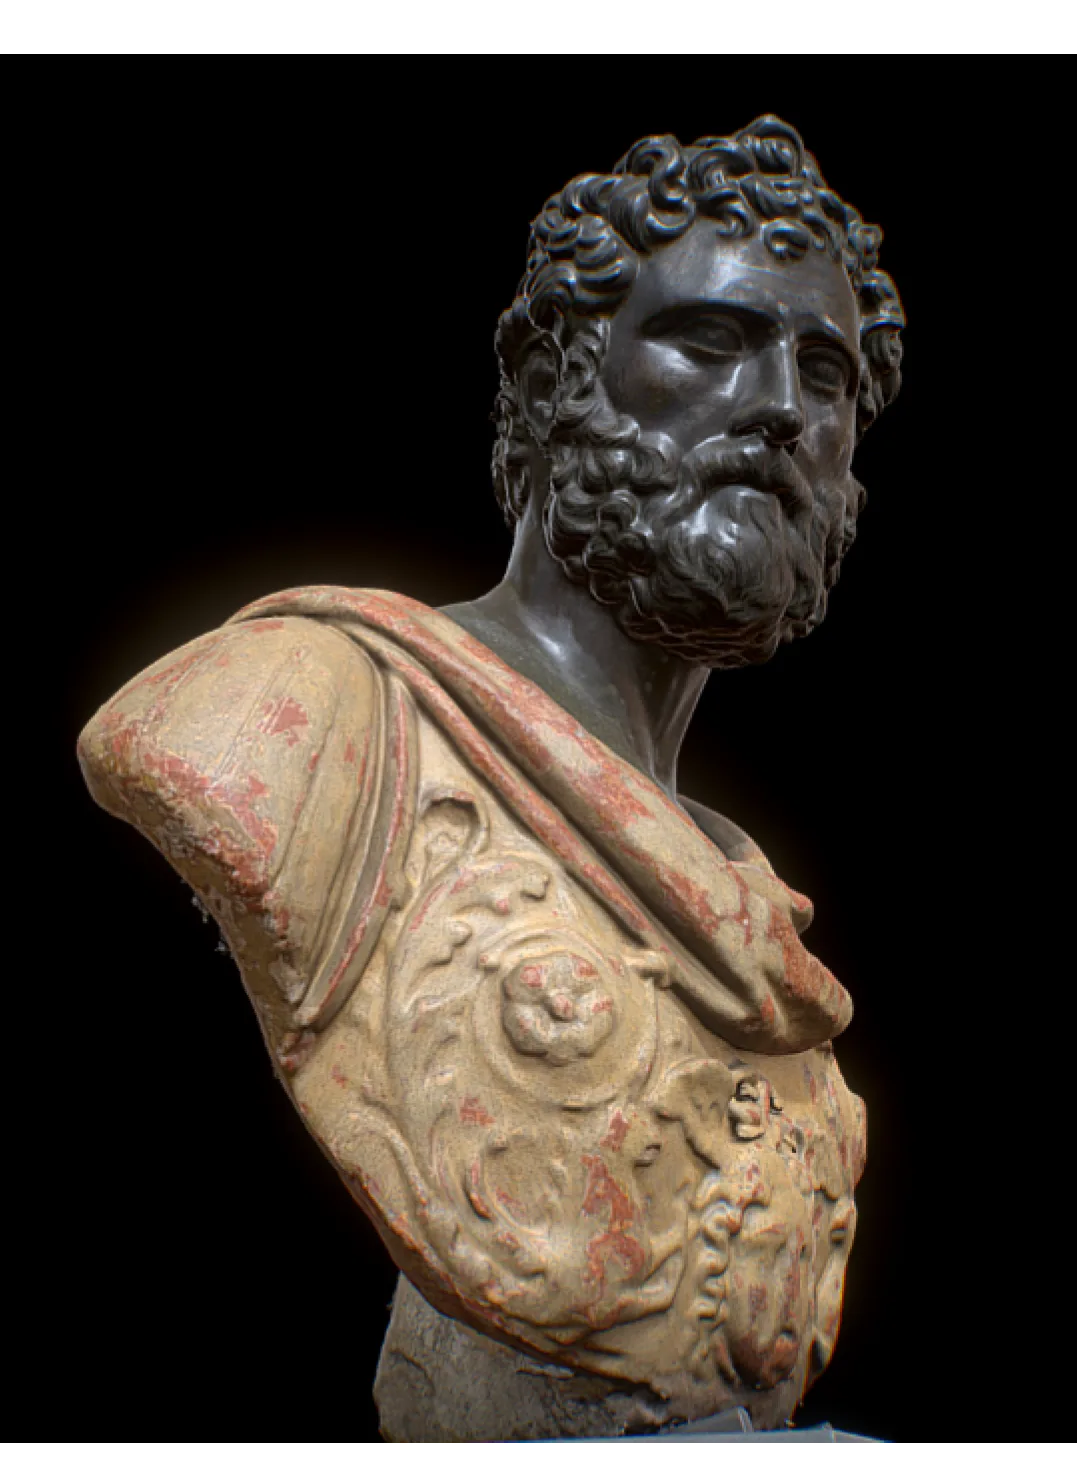
Workflow complessi su nodi locali
Qualsiasi workflow di elaborazione, anche complesso, si imposta rapidamente sulla rete di nodi tramite il job scheduler. Per ogni passo, il router sceglie la macchina autorizzata a eseguirlo, verifica che la sua capacità sia reale, recupera dai guasti e valida l'output.
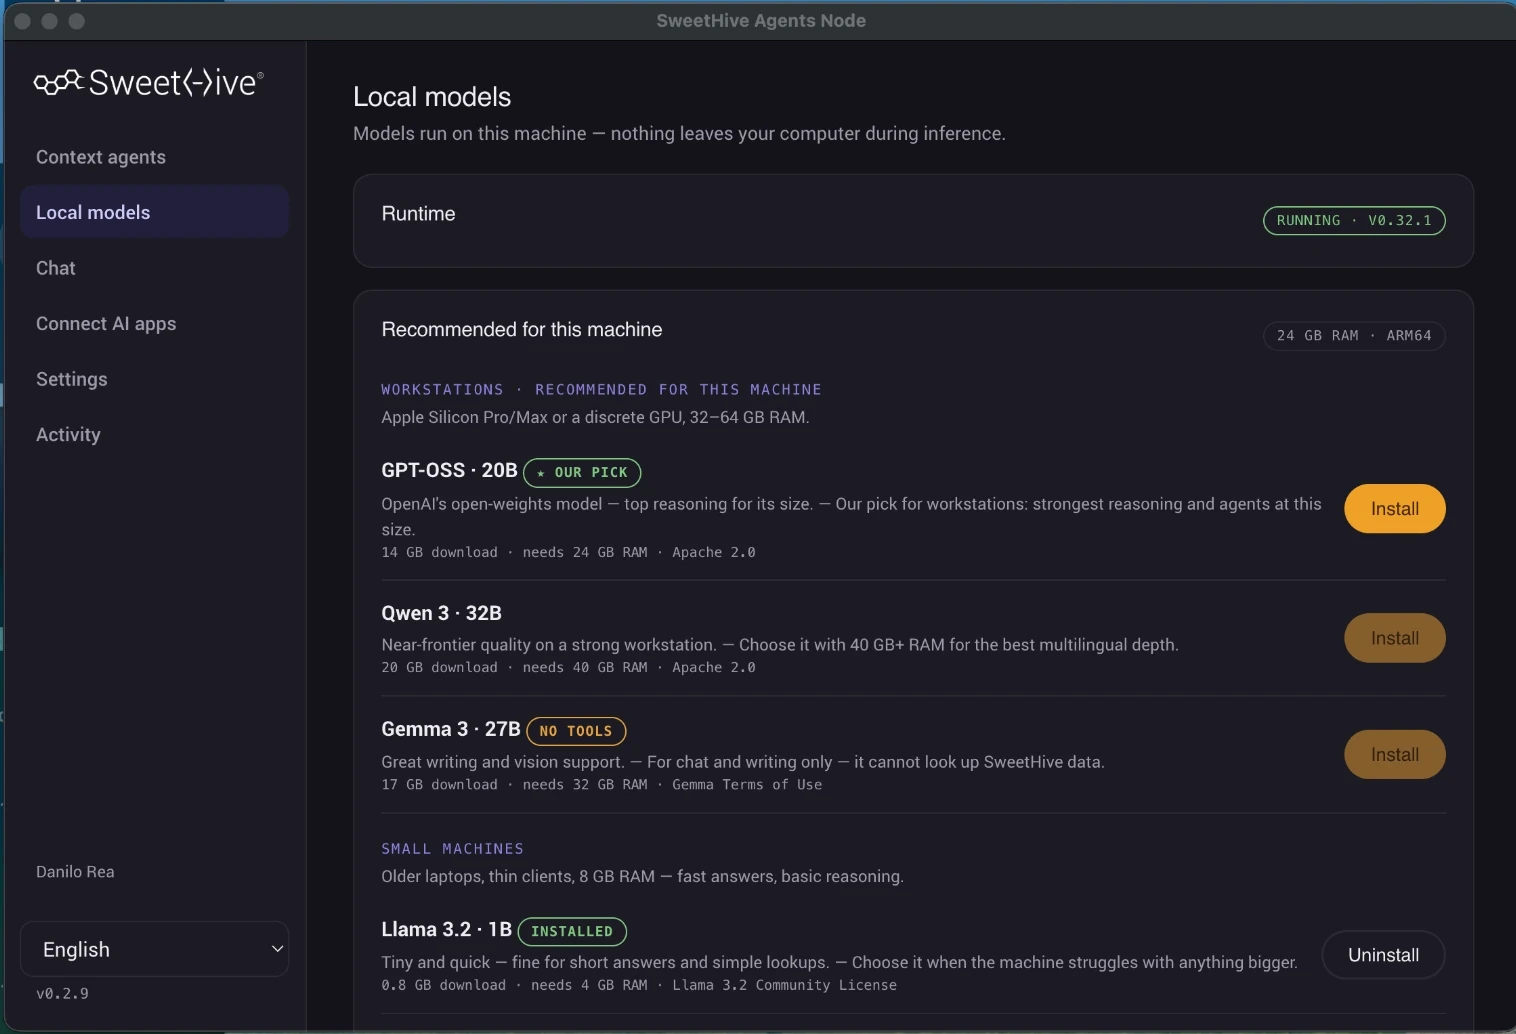
AI locale, gestita con semplicità
I modelli girano sui vostri nodi locali e li teniamo aggiornati noi. Gli agenti privati sanno solo ciò che i vostri team consentono, e nulla esce senza una policy.
Strumenti e accesso in tempo reale da qualsiasi dispositivo
Dati pesanti in streaming dai nodi remoti verso hub, viewer e app su qualsiasi dispositivo, senza che i dati sorgente vengano mai copiati sui dispositivi degli utenti.
Provato dove i dati sono più difficili.
Non abbiamo validato TrustTwin OS in laboratorio. Lo abbiamo validato nei musei europei: dati 3D pesanti, oggetti insostituibili, regole rigorose su dove i dati possono andare.
Un ambiente dove i fallimenti costano e i dati non si possono semplicemente spostare o ricreare. Per questo AerariumChain è venuto per primo. Ora SweetHive porta lo stesso OS alle piccole e medie imprese.
TrustTwin OS Core.
Nei prossimi anni l'OS stesso diventa il prodotto: in white label per i partner, o come infrastruttura di base che le aziende eseguono sui propri nodi. Oggi lo stiamo costruendo con partner e primi design partner.
Dove si ripete lo stesso pattern
File grandi, dataset privati, collaborazione con i partner, picchi GPU, hosting controllato, obblighi di audit.
Il controllo fa parte dell'architettura.
La data residency è imposta, non promessa. Configura elaborazione locale, privata, solo UE o specifica per paese, con profili solo UE che escludono del tutto i provider non europei.
Dove vivono i dati.
Dove girano i workload.
Dove avviene l'inferenza.
Se una regola di residenza non può essere garantita, il workload non parte.
Particolarmente prezioso per i deployment europei. Il modello di controllo sottostante è rilevante a livello globale.
Un'architettura sola. Dall'AI privata ai digital twin più pesanti.
Per partner, pilot e primi design partner: raccontateci i vostri dati e i vostri workload, e vi mostreremo come TrustTwin OS li esegue sui vostri nodi, secondo le vostre policy.