Entre le début et la fin du mois de septembre, quatre ensembles de données distincts ont pointé dans la même direction. Sur les plateformes qui acheminent le trafic d'IA de milliers d'entreprises, les modèles open-weight, ceux dont chacun peut télécharger et exécuter les poids, traitent désormais davantage de tokens que les modèles propriétaires. Il y a un an, ils restaient une niche.
Le basculement est réel, mais il est facile de mal l'interpréter. Observer où va l'argent raconte une autre histoire, et l'écart entre les deux constitue l'enseignement le plus utile.
Ce que montrent les données
- Vercel AI Gateway, 17 septembre. Les modèles open-weight ont traité 56 % de l'ensemble des tokens de la passerelle en août 2026, contre 13 % en avril et moins d'un sur dix en décembre 2025. C'est le premier mois où ils sont majoritaires.
- OpenRouter, selon CNBC le 26 septembre. Les modèles chinois, presque tous open-weight (DeepSeek, Qwen, GLM, Kimi), représentaient entre 57 % et 67 % des tokens la semaine du 14 septembre, contre 6 % à 13 % en février. En juillet, les données d'OpenRouter rapportées par Bloomberg situaient déjà leur part des tokens utilisés par les entreprises américaines sur la plateforme à un record d'environ 58 %.
- Ramp AI Index, 9 septembre. Parmi les entreprises américaines, la part des tokens destinés aux modèles de pointe est passée d'un pic de 53 % en août à 45 %, les entreprises adoptant par défaut des modèles moins coûteux. Le prix moyen payé par million de tokens a reculé de 41 % par rapport à son pic de mars, à 0,68 $.
- Enquête d'Enterprise Technology Research, septembre. Les modèles open-weight représentent 34 % de l'utilisation de tokens en entreprise, contre 23 % un an plus tôt, et les répondants anticipent 41 % d'ici douze mois. 42 % des entreprises exploitent au moins un modèle open-weight en production. Le coût en est la principale raison (69 %), suivi du contrôle.
Les tokens ne sont pas des dollars
Les mêmes sources montrent les limites de la tendance. Chez Vercel, les 56 % de tokens traités par des modèles open-weight ne correspondaient qu'à 14 % des dépenses. Dans les données de Ramp, seules 6,4 % des entreprises américaines qui paient pour de l'IA paient pour des modèles open source, alors que 43,8 % paient Anthropic et 39,8 % OpenAI. Les enquêtes menées plus tôt dans l'année auprès des DSI de grandes entreprises montraient encore une préférence pour les modèles fermés, au nom de la qualité, de la sécurité et du manque de compétences internes en IA.
Il existe aussi des angles morts. Les plateformes de routage surreprésentent les développeurs et les start-up à croissance rapide. Ramp voit les paiements par carte et sur facture : il ne peut donc pas voir un modèle ouvert exécuté sur les propres serveurs d'une entreprise, précisément là où se trouvent de nombreux déploiements open-weight. La tendance n'a pas non plus commencé ce mois-ci : elle se construit depuis le début de 2026 et a franchi la barre de la moitié au cours de l'été.
La lecture juste est la suivante : les entreprises déplacent leur volume, pas leurs travaux les plus critiques. Les tâches répétitives à fort volume (classification, extraction, résumés, sous-étapes des workflows d'agents, boucles de code) partent vers des modèles open-weight qui coûtent une fraction par token. Le raisonnement complexe et les tâches où une erreur coûte cher restent sur les modèles propriétaires de pointe.
Vous devez décider quels travaux peuvent passer sur des modèles ouverts, et où ils doivent s'exécuter ? Échangez avec l'équipe TrustTwin OS.
Pourquoi l'enjeu est plus important en Europe
Pour les entreprises américaines, le moteur est surtout le coût. Pour les organisations européennes, une seconde raison peut peser davantage : un modèle open-weight peut s'exécuter là où vous le décidez. Sur vos propres serveurs, sur un nœud situé dans un pays donné, sur une infrastructure exclusivement européenne ou sur l'ordinateur portable d'un collaborateur. Les données n'ont pas à transiter par l'API d'un fournisseur pour être traitées.
Cette liberté s'accompagne de ses propres contraintes.
- Poids ouverts ne signifie pas données ouvertes. Vous pouvez inspecter et exécuter le modèle, pas les données sur lesquelles il a été entraîné.
- Les licences diffèrent. Apache 2.0, les licences communautaires Llama et les conditions de Gemma n'autorisent pas les mêmes usages.
- La provenance est examinée. Dans l'enquête ETR, 62 % des entreprises citent les revues de sécurité et de conformité comme principal obstacle, et plusieurs des modèles les plus utilisés proviennent de laboratoires chinois.
- Il faut quelqu'un pour les exploiter. Les coûts d'hébergement, les mises à jour et le dimensionnement matériel ne disparaissent pas parce que la licence est gratuite.
Du choix d'un modèle au routage des travaux
Lorsque chaque entreprise utilise plusieurs modèles, la véritable décision n'est plus de savoir quel modèle acheter. Elle consiste à déterminer quel modèle traite quelles données, sur quelle machine. C'est un problème de routage et de politique, et c'est celui que TrustTwin OS a été conçu pour résoudre.
- Des modèles locaux, simples à gérer. Avec Agents Node, les modèles open-weight s'exécutent sur les propres machines de l'entreprise et nous les maintenons à jour. Pendant l'inférence, rien ne quitte l'ordinateur.
- Des agents privés aux connaissances circonscrites. Un agent ne connaît que ce que le contexte dans lequel il travaille autorise, quel que soit le modèle qui le sous-tend.
- La politique avant le placement. La sensibilité et la résidence des données sont vérifiées avant l'exécution d'un workload. Les travaux qui doivent rester locaux restent locaux ; si une règle de résidence ne peut pas être garantie, le workload ne s'exécute pas.
- Une trace de chaque décision. Le lieu d'exécution de chaque tâche est journalisé, afin que le choix du modèle et de la machine puisse être audité ultérieurement.
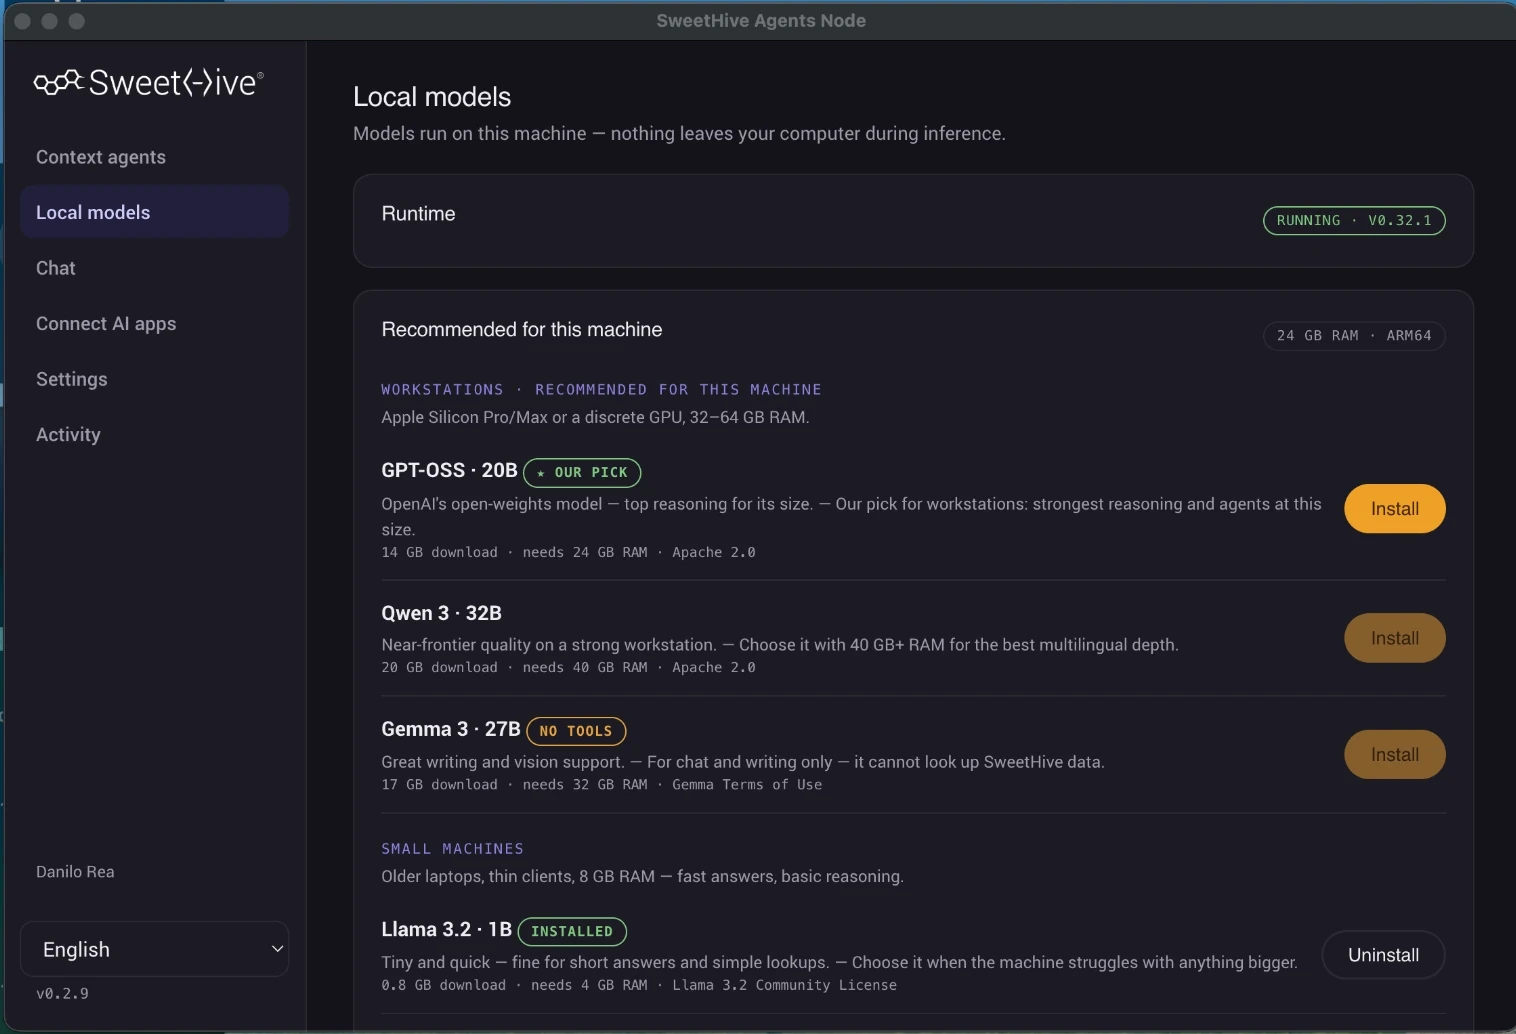
La même approche est mise en œuvre dans SweetHive, où les petites entreprises peuvent choisir des modèles locaux pour leurs agents et conserver fichiers et prompts sur leur propre matériel.
Trois questions pour le prochain budget
- Lesquels de nos workloads d'IA sont routiniers et à fort volume, et combien coûteraient-ils sur un modèle open-weight ?
- Quelles données ne doivent jamais quitter nos machines, notre pays ou l'UE, et nos outils actuels le respectent-ils dès la conception ?
- Si nous utilisons plusieurs modèles demain, qui décide lequel voit quelles données, et où cette décision est-elle consignée ?
Le passage aux modèles open-weight n'est pas un vote contre les modèles de pointe. C'est le début d'une architecture mixte, et dans une architecture mixte, l'avantage revient à celui qui gouverne le routage.
Sources
- Vercel, AI Gateway Production Index, 17 septembre 2026 : vercel.com/blog
- CNBC, sur la part des modèles chinois dans le trafic d'OpenRouter, 26 septembre 2026 : cnbc.com
- AI Weekly, résumant Bloomberg sur les données d'OpenRouter relatives aux entreprises américaines, 22 juillet 2026 : aiweekly.co
- Ramp, AI Index, 9 septembre 2026 : ramp.com/data/ai-index-sept-2026
- Techstrong.ai sur l'enquête d'Enterprise Technology Research, septembre 2026 : techstrong.ai
- a16z, enquête auprès des DSI d'entreprise, 2026 : a16z.com