Tra l'inizio e la fine di settembre, quattro serie di dati distinte hanno indicato la stessa direzione. Sulle piattaforme che instradano il traffico AI per migliaia di aziende, i modelli open-weight, quelli i cui pesi chiunque può scaricare ed eseguire, elaborano ormai più token dei modelli proprietari. Un anno fa erano una nicchia.
Il cambiamento è reale, ma è facile interpretarlo male. Guardare a dove va il denaro racconta una storia diversa, e il divario tra le due letture è la parte più utile.
Che cosa mostrano i dati
- Vercel AI Gateway, 17 settembre. Ad agosto 2026 i modelli open-weight hanno elaborato il 56% di tutti i token sul gateway, rispetto al 13% di aprile e a meno di uno su dieci a dicembre 2025. È il primo mese in cui detengono la maggioranza.
- OpenRouter, secondo quanto riportato da CNBC il 26 settembre. I modelli cinesi, quasi tutti open-weight (DeepSeek, Qwen, GLM, Kimi), hanno rappresentato tra il 57% e il 67% dei token nella settimana del 14 settembre, contro il 6-13% di febbraio. Già a luglio i dati di OpenRouter riportati da Bloomberg collocavano la loro quota di token utilizzati dalle aziende statunitensi sulla piattaforma al livello record di circa il 58%.
- Ramp AI Index, 9 settembre. Tra le imprese statunitensi, la quota di token destinata ai modelli di frontiera è scesa da un picco del 53% ad agosto al 45%, poiché le aziende impostano modelli più economici come predefiniti. Il prezzo medio pagato per milione di token è calato del 41% rispetto al picco di marzo, a 0,68 dollari.
- Indagine di Enterprise Technology Research, settembre. I modelli open-weight rappresentano il 34% dell'utilizzo di token nelle imprese, rispetto al 23% di un anno prima, e gli intervistati prevedono il 41% entro dodici mesi. Il 42% delle aziende utilizza in produzione almeno un modello open-weight. Il costo è la ragione principale (69%), seguito dal controllo.
I token non sono dollari
Le stesse fonti mostrano i limiti della tendenza. Su Vercel, il 56% dei token gestiti dai modelli open-weight corrispondeva ad appena il 14% della spesa. Nei dati di Ramp, solo il 6,4% delle imprese statunitensi che pagano per l'AI paga per modelli open source, mentre il 43,8% paga Anthropic e il 39,8% paga OpenAI. Le indagini condotte all'inizio dell'anno tra i CIO delle grandi aziende mostravano ancora una preferenza per i modelli chiusi, motivata da qualità, sicurezza e mancanza di competenze AI interne.
Esistono anche punti ciechi. Le piattaforme di routing sovrarappresentano sviluppatori e startup in rapida crescita. Ramp vede i pagamenti con carta e fattura, quindi non può rilevare un modello aperto eseguito sui server di un'azienda, che è esattamente dove si trovano molte implementazioni open-weight. Né la tendenza è iniziata questo mese: si sta consolidando dall'inizio del 2026 e ha superato la soglia della metà durante l'estate.
La lettura corretta è questa: le aziende stanno spostando i volumi, non il lavoro più critico. Le attività ripetitive ad alto volume (classificazione, estrazione, riassunti, i passaggi intermedi dei workflow degli agenti, i cicli di coding) passano a modelli open-weight che costano una frazione per token. Il ragionamento complesso e le attività in cui un errore è costoso restano sui modelli proprietari di frontiera.
Sta valutando quali attività spostare sui modelli aperti e dove eseguirle? Contatti il team di TrustTwin OS.
Perché in Europa conta di più
Per le aziende statunitensi il fattore trainante è soprattutto il costo. Per le organizzazioni europee esiste una seconda ragione che può pesare di più: un modello open-weight può essere eseguito ovunque si decida. Sui propri server, su un nodo in un determinato Paese, su un'infrastruttura esclusivamente UE o sul portatile di un dipendente. I dati non devono raggiungere l'API di un fornitore per essere elaborati.
Questa libertà comporta un lavoro specifico.
- Pesi aperti non significa dati aperti. Si può ispezionare ed eseguire il modello, non i dati su cui è stato addestrato.
- Le licenze sono diverse. Apache 2.0, le licenze community di Llama e i termini di Gemma non consentono le stesse cose.
- La provenienza viene verificata. Nell'indagine ETR, il 62% delle aziende ha indicato le verifiche di sicurezza e conformità come ostacolo principale, e diversi tra i modelli più utilizzati provengono da laboratori cinesi.
- Qualcuno deve gestirli. Costi di hosting, aggiornamenti e dimensionamento dell'hardware non scompaiono perché la licenza è gratuita.
Dalla scelta di un modello all'instradamento del lavoro
Quando ogni azienda utilizza più modelli, la vera decisione non è più quale modello acquistare, ma quale modello tratta quali dati, su quale macchina. È un problema di routing e di policy, ed è quello che TrustTwin OS è stato progettato per risolvere.
- Modelli locali, gestiti con semplicità. Con Agents Node, i modelli open-weight vengono eseguiti sulle macchine dell'azienda e noi li manteniamo aggiornati. Durante l'inferenza, nulla esce dal computer.
- Agenti privati con conoscenza circoscritta. Un agente conosce solo ciò che il contesto in cui opera consente, qualunque sia il modello sottostante.
- La policy prima della collocazione. Sensibilità dei dati e data residency vengono verificate prima dell'esecuzione di un workload. Il lavoro che deve restare locale resta locale; se una regola di residency non può essere garantita, il workload non viene eseguito.
- Una traccia di ogni decisione. Il luogo di esecuzione di ogni attività viene registrato, così la scelta del modello e della macchina può essere verificata in seguito.
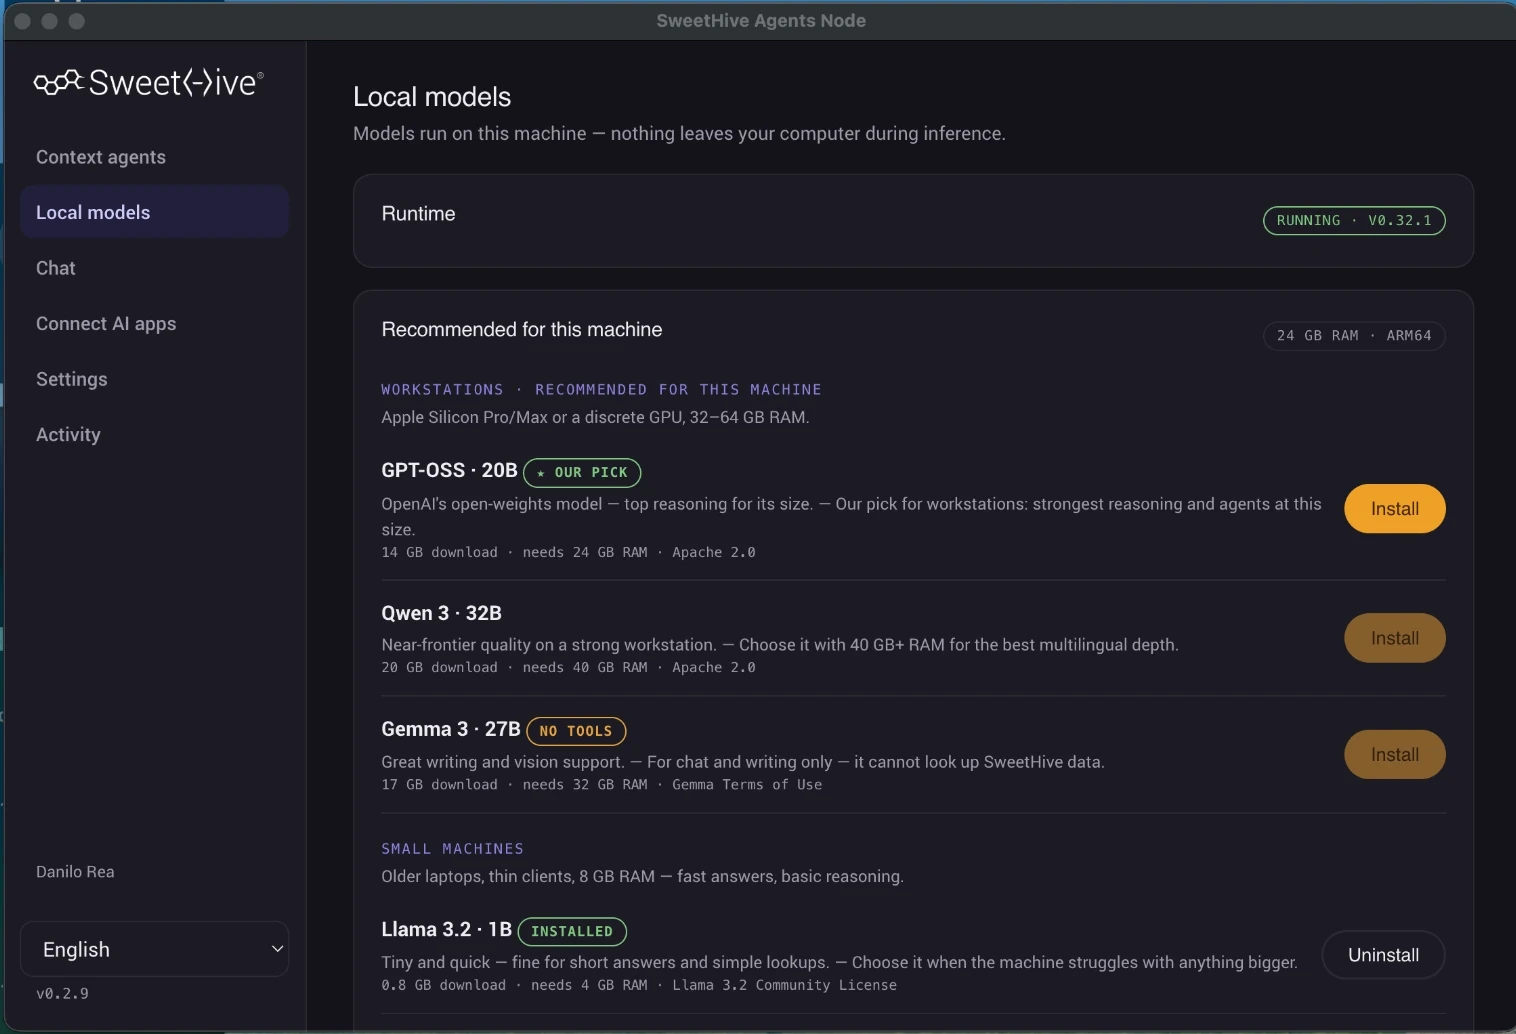
Lo stesso approccio è adottato in SweetHive, dove le piccole aziende possono scegliere modelli locali per i propri agenti e mantenere file e prompt sul proprio hardware.
Tre domande per il prossimo budget
- Quali dei nostri workload AI sono ad alto volume e di routine, e quanto costerebbero su un modello open-weight?
- Quali dati non devono mai lasciare le nostre macchine, il nostro Paese o l'UE, e gli strumenti attuali lo garantiscono by design?
- Se domani utilizzeremo più modelli, chi decide quale modello vede quali dati, e dove viene registrata questa decisione?
Il passaggio ai modelli open-weight non è un voto contro i modelli di frontiera. È l'inizio di un assetto misto, e in un assetto misto il vantaggio va a chi governa il routing.
Fonti
- Vercel, AI Gateway Production Index, 17 settembre 2026: vercel.com/blog
- CNBC, sulla quota dei modelli cinesi nel traffico di OpenRouter, 26 settembre 2026: cnbc.com
- AI Weekly, sintesi di Bloomberg sui dati OpenRouter relativi alle aziende statunitensi, 22 luglio 2026: aiweekly.co
- Ramp, AI Index, 9 settembre 2026: ramp.com/data/ai-index-sept-2026
- Techstrong.ai sull'indagine di Enterprise Technology Research, settembre 2026: techstrong.ai
- a16z, indagine sui CIO delle imprese, 2026: a16z.com