Entre principios y finales de septiembre, cuatro conjuntos de datos independientes apuntaron en la misma dirección. En las plataformas que enrutan el tráfico de IA de miles de empresas, los modelos open-weight, aquellos cuyos pesos cualquiera puede descargar y ejecutar, procesan ya más token que los modelos propietarios. Hace un año eran un nicho.
El cambio es real, pero es fácil malinterpretarlo. Observar adónde va el dinero cuenta otra historia, y la diferencia entre ambas es la parte más útil.
Qué muestran los datos
- Vercel AI Gateway, 17 de septiembre. Los modelos open-weight procesaron el 56 % de todos los token del gateway en agosto de 2026, frente al 13 % de abril y menos de uno de cada diez en diciembre de 2025. Es el primer mes en que alcanzan la mayoría.
- OpenRouter, según informó CNBC el 26 de septiembre. Los modelos chinos, casi todos open-weight (DeepSeek, Qwen, GLM, Kimi), representaron entre el 57 % y el 67 % de los token en la semana del 14 de septiembre, frente al 6 % a 13 % de febrero. En julio, los datos de OpenRouter publicados por Bloomberg ya situaban su cuota de token utilizados por empresas estadounidenses en la plataforma en un récord de aproximadamente el 58 %.
- Ramp AI Index, 9 de septiembre. Entre las empresas estadounidenses, la proporción de token destinados a modelos frontier cayó de un máximo del 53 % en agosto al 45 %, a medida que las empresas fijaban modelos más económicos como opción predeterminada. El precio medio pagado por millón de token bajó un 41 % desde su máximo de marzo, hasta 0,68 $.
- Encuesta de Enterprise Technology Research, septiembre. Los modelos open-weight representan el 34 % del uso de token en las empresas, frente al 23 % de un año antes, y los encuestados prevén un 41 % en doce meses. El 42 % de las empresas tiene al menos un modelo open-weight en producción. El coste es el motivo principal (69 %), seguido del control.
Los token no son dólares
Las mismas fuentes muestran los límites de la tendencia. En Vercel, el 56 % de los token gestionados por modelos open-weight correspondió solo al 14 % del gasto. En los datos de Ramp, solo el 6,4 % de las empresas estadounidenses que pagan por IA pagan por modelos de código abierto, mientras que el 43,8 % paga a Anthropic y el 39,8 % a OpenAI. Las encuestas a CIO de grandes empresas realizadas a principios de este año seguían mostrando preferencia por los modelos cerrados, por motivos de calidad, seguridad y falta de competencias internas en IA.
También hay puntos ciegos. Las plataformas de enrutamiento sobrerrepresentan a desarrolladores y startups de rápido crecimiento. Ramp ve pagos con tarjeta y facturas, por lo que no puede ver un modelo abierto que se ejecuta en los servidores propios de una empresa, que es precisamente donde residen muchos despliegues open-weight. Además, la tendencia no empezó este mes: se ha ido consolidando desde principios de 2026 y superó la mitad durante el verano.
La lectura justa es esta: las empresas están trasladando su volumen, no su trabajo más crítico. Las tareas repetitivas y de gran volumen (clasificación, extracción, resúmenes, los subpasos de los flujos de agentes, los ciclos de programación) pasan a modelos open-weight que cuestan una fracción por token. El razonamiento complejo y las tareas en las que un error resulta caro permanecen en modelos propietarios frontier.
¿Está decidiendo qué trabajo puede pasar a modelos abiertos y dónde deberían ejecutarse? Hable con el equipo de TrustTwin OS.
Por qué importa más en Europa
Para las empresas estadounidenses, el motor es sobre todo el coste. Para las organizaciones europeas existe un segundo motivo que puede pesar más: un modelo open-weight puede ejecutarse donde la organización decida. En sus propios servidores, en un nodo de un país concreto, en una infraestructura exclusivamente europea o en el portátil de un empleado. Los datos no tienen que viajar a la API de un proveedor para ser procesados.
Esa libertad conlleva su propio trabajo.
- Pesos abiertos no significa datos abiertos. Se puede inspeccionar y ejecutar el modelo, no los datos con los que se entrenó.
- Las licencias difieren. Apache 2.0, las licencias comunitarias de Llama y las condiciones de Gemma no permiten lo mismo.
- La procedencia se revisa. En la encuesta de ETR, el 62 % de las empresas señaló las revisiones de seguridad y cumplimiento como el principal obstáculo, y varios de los modelos más utilizados proceden de laboratorios chinos.
- Alguien tiene que gestionarlos. Los costes de alojamiento, las actualizaciones y el dimensionamiento del hardware no desaparecen porque la licencia sea gratuita.
De elegir un modelo a enrutar el trabajo
Cuando cada empresa utiliza varios modelos, la verdadera decisión ya no es qué modelo comprar. Es qué modelo trata qué datos y en qué máquina. Se trata de un problema de enrutamiento y de políticas, y es el que TrustTwin OS se creó para resolver.
- Modelos locales, de gestión sencilla. Con Agents Node, los modelos open-weight se ejecutan en las máquinas de la propia empresa y nosotros los mantenemos actualizados. Durante la inferencia, nada sale del ordenador.
- Agentes privados con conocimiento acotado. Un agente solo conoce lo que permite el contexto en el que trabaja, sea cual sea el modelo que lo respalda.
- La política antes de la ubicación. La sensibilidad de los datos y la data residency se comprueban antes de ejecutar un workload. El trabajo que debe permanecer en local permanece en local; si no se puede garantizar una regla de residencia, el workload no se ejecuta.
- Un registro de cada decisión. Se registra dónde se ejecutó cada tarea, de modo que la elección de modelo y máquina pueda auditarse posteriormente.
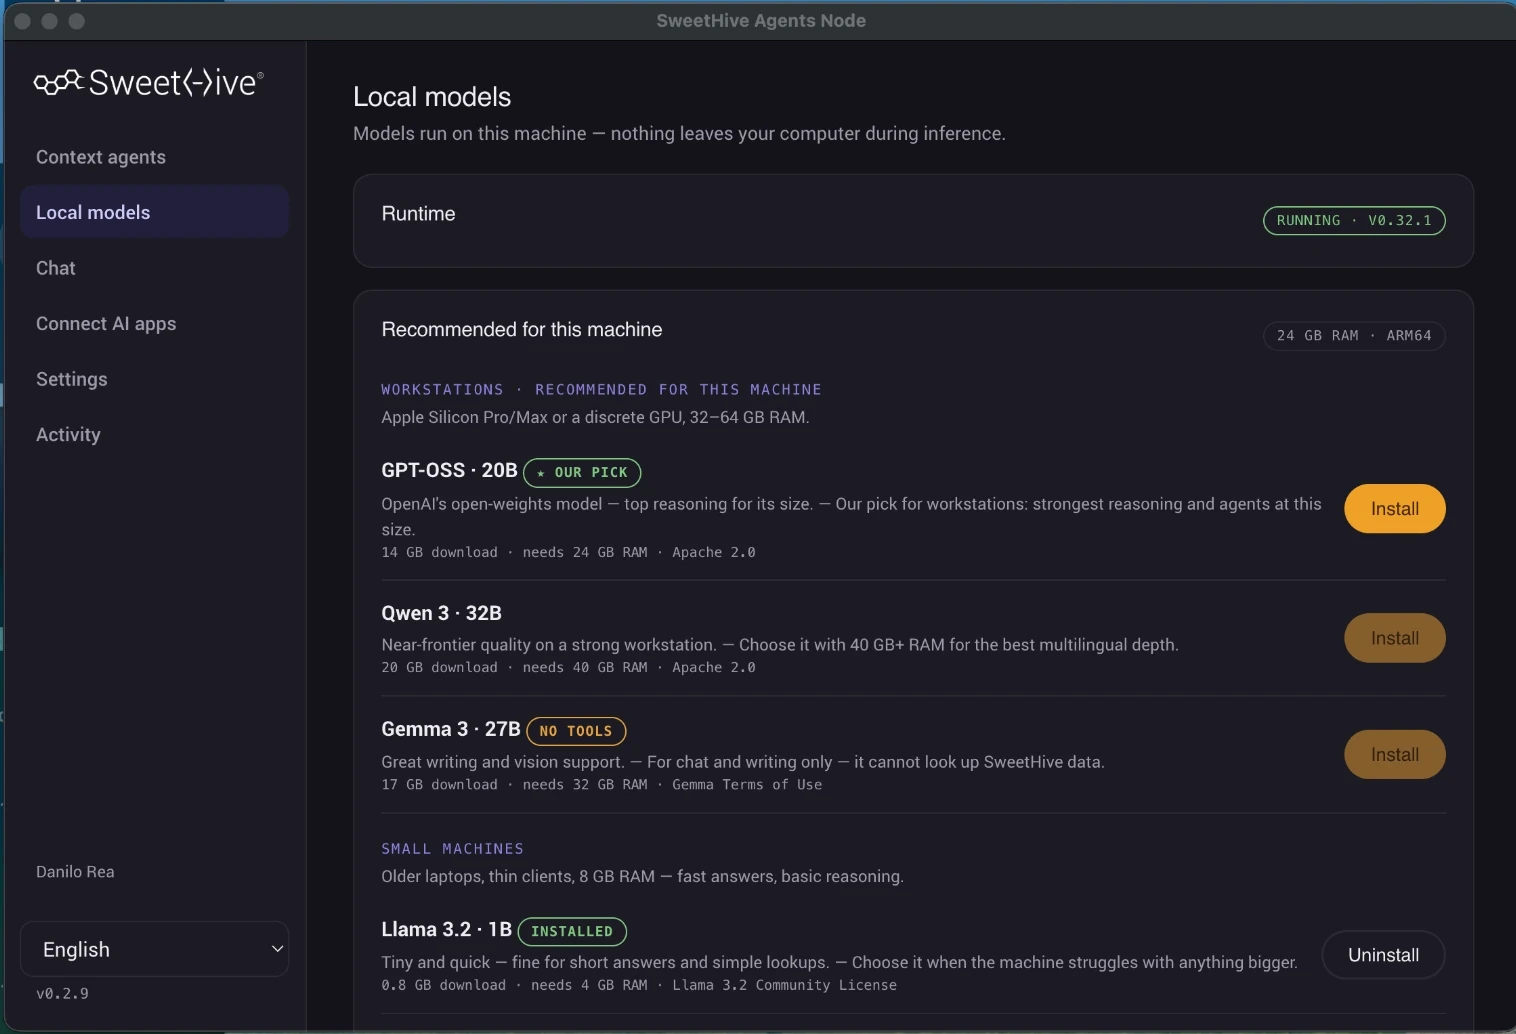
El mismo enfoque se aplica en SweetHive, donde las pequeñas empresas pueden elegir modelos locales para sus agentes y mantener archivos y prompts en su propio hardware.
Tres preguntas para el próximo presupuesto
- ¿Cuáles de nuestros workload de IA son rutinarios y de gran volumen, y cuánto costarían en un modelo open-weight?
- ¿Qué datos no deben salir nunca de nuestras máquinas, de nuestro país o de la UE, y respetan nuestras herramientas actuales ese requisito desde el diseño?
- Si mañana utilizamos varios modelos, ¿quién decide cuál ve qué datos y dónde queda registrada esa decisión?
El paso a los modelos open-weight no es un voto en contra de los modelos frontier. Es el inicio de un entorno mixto, y en un entorno mixto la ventaja es para quien gobierna el enrutamiento.
Fuentes
- Vercel, AI Gateway Production Index, 17 de septiembre de 2026: vercel.com/blog
- CNBC, sobre la cuota de los modelos chinos en el tráfico de OpenRouter, 26 de septiembre de 2026: cnbc.com
- AI Weekly, resumen de Bloomberg sobre los datos de OpenRouter para empresas estadounidenses, 22 de julio de 2026: aiweekly.co
- Ramp, AI Index, 9 de septiembre de 2026: ramp.com/data/ai-index-sept-2026
- Techstrong.ai sobre la encuesta de Enterprise Technology Research, septiembre de 2026: techstrong.ai
- a16z, encuesta a CIO de empresas, 2026: a16z.com