Zwischen Anfang und Ende September wiesen vier voneinander unabhängige Datensätze in dieselbe Richtung. Auf den Plattformen, die den KI-Datenverkehr Tausender Unternehmen routen, verarbeiten Open-Weight-Modelle, also jene, deren Gewichte jeder herunterladen und selbst betreiben kann, inzwischen mehr Token als proprietäre Modelle. Vor einem Jahr waren sie noch eine Nische.
Die Verschiebung ist real, wird aber leicht falsch gedeutet. Ein Blick darauf, wohin das Geld fließt, ergibt ein anderes Bild, und gerade die Lücke zwischen beiden ist der aufschlussreichste Teil.
Was die Daten zeigen
- Vercel AI Gateway, 17. September. Open-Weight-Modelle verarbeiteten im August 2026 56 % aller Token auf dem Gateway, nach 13 % im April und weniger als einem von zehn im Dezember 2025. Es ist der erste Monat, in dem sie eine Mehrheit stellen.
- OpenRouter, laut CNBC vom 26. September. Chinesische Modelle, nahezu alle Open-Weight (DeepSeek, Qwen, GLM, Kimi), entfielen in der Woche vom 14. September auf 57 % bis 67 % der Token, gegenüber 6 % bis 13 % im Februar. Bereits im Juli bezifferten von Bloomberg berichtete OpenRouter-Daten ihren Anteil an den Token, die US-Unternehmen auf der Plattform nutzten, auf einen Rekordwert von rund 58 %.
- Ramp AI Index, 9. September. Bei US-Unternehmen sank der Anteil der Token, die an Frontier-Modelle gehen, von einem Höchststand von 53 % im August auf 45 %, da Unternehmen günstigere Modelle als Standard festlegen. Der durchschnittlich gezahlte Preis pro Million Token fiel gegenüber dem Höchststand im März um 41 % auf 0,68 $.
- Umfrage von Enterprise Technology Research, September. Open-Weight-Modelle machen 34 % der Token-Nutzung in Unternehmen aus, nach 23 % ein Jahr zuvor, und die Befragten erwarten binnen zwölf Monaten 41 %. 42 % der Unternehmen betreiben mindestens ein Open-Weight-Modell im Produktivbetrieb. Hauptgrund sind die Kosten (69 %), gefolgt von Kontrolle.
Token sind keine Dollar
Dieselben Quellen zeigen auch die Grenzen des Trends. Bei Vercel entsprachen die 56 % der Token, die auf Open-Weight-Modelle entfielen, nur 14 % der Ausgaben. In den Ramp-Daten zahlen lediglich 6,4 % der US-Unternehmen, die für KI bezahlen, für Open-Source-Modelle, während 43,8 % an Anthropic und 39,8 % an OpenAI zahlen. Umfragen unter CIOs großer Unternehmen zeigten Anfang dieses Jahres weiterhin eine Präferenz für geschlossene Modelle, begründet mit Qualität, Sicherheit und fehlender interner KI-Kompetenz.
Es gibt zudem blinde Flecken. Routing-Plattformen bilden Entwickler und schnell wachsende Start-ups überproportional ab. Ramp erfasst Karten- und Rechnungszahlungen und kann daher kein offenes Modell sehen, das auf den eigenen Servern eines Unternehmens läuft, also genau dort, wo viele Open-Weight-Bereitstellungen angesiedelt sind. Auch begann der Trend nicht erst in diesem Monat: Er baut sich seit Anfang 2026 auf und überschritt im Sommer die Hälfte.
Die faire Lesart lautet: Unternehmen verlagern ihr Volumen, nicht ihre kritischste Arbeit. Repetitive Aufgaben mit hohem Volumen (Klassifizierung, Extraktion, Zusammenfassungen, die Teilschritte von Agenten-Workflows, Coding-Schleifen) wandern zu Open-Weight-Modellen, die pro Token nur einen Bruchteil kosten. Anspruchsvolles Reasoning und Aufgaben, bei denen ein Fehler teuer ist, verbleiben bei proprietären Frontier-Modellen.
Sie entscheiden gerade, welche Arbeit auf offene Modelle wechseln kann und wo diese laufen sollen? Sprechen Sie mit dem TrustTwin OS Team.
Warum das in Europa stärker ins Gewicht fällt
Für US-Unternehmen sind vor allem die Kosten der Treiber. Für europäische Organisationen gibt es einen zweiten Grund, der schwerer wiegen kann: Ein Open-Weight-Modell kann dort laufen, wo Sie es bestimmen. Auf Ihren eigenen Servern, auf einem Knoten in einem bestimmten Land, auf einer ausschließlich europäischen Infrastruktur oder auf dem Laptop eines Mitarbeiters. Die Daten müssen zur Verarbeitung nicht an die API eines Anbieters übermittelt werden.
Diese Freiheit bringt eigenen Aufwand mit sich.
- Offene Gewichte sind keine offenen Daten. Sie können das Modell prüfen und betreiben, nicht jedoch die Daten, mit denen es trainiert wurde.
- Lizenzen unterscheiden sich. Apache 2.0, die Llama-Community-Lizenzen und die Gemma-Nutzungsbedingungen erlauben nicht dasselbe.
- Die Herkunft wird geprüft. In der ETR-Umfrage nannten 62 % der Unternehmen Sicherheits- und Compliance-Prüfungen als größtes Hindernis, und mehrere der meistgenutzten Modelle stammen aus chinesischen Labs.
- Jemand muss sie betreiben. Hosting-Kosten, Updates und die Dimensionierung der Hardware verschwinden nicht, nur weil die Lizenz kostenlos ist.
Von der Modellwahl zum Routing der Arbeit
Wenn jedes Unternehmen mehrere Modelle nutzt, lautet die eigentliche Entscheidung nicht mehr, welches Modell man kauft, sondern welches Modell welche Daten auf welcher Maschine verarbeitet. Das ist ein Routing- und Policy-Problem, und genau für dessen Lösung wurde TrustTwin OS entwickelt.
- Lokale Modelle, einfach verwaltet. Mit Agents Node laufen Open-Weight-Modelle auf den eigenen Rechnern des Unternehmens, und wir halten sie aktuell. Während der Inferenz verlässt nichts den Computer.
- Private Agenten mit abgegrenztem Wissen. Ein Agent weiß nur, was der Kontext, in dem er arbeitet, zulässt, unabhängig davon, welches Modell dahintersteht.
- Policy vor Platzierung. Datensensibilität und Data Residency werden geprüft, bevor ein Workload ausgeführt wird. Was lokal bleiben muss, bleibt lokal; kann eine Residency-Regel nicht garantiert werden, wird der Workload nicht ausgeführt.
- Eine Aufzeichnung jeder Entscheidung. Wo jeder Auftrag ausgeführt wurde, wird protokolliert, sodass die Wahl von Modell und Maschine später auditiert werden kann.
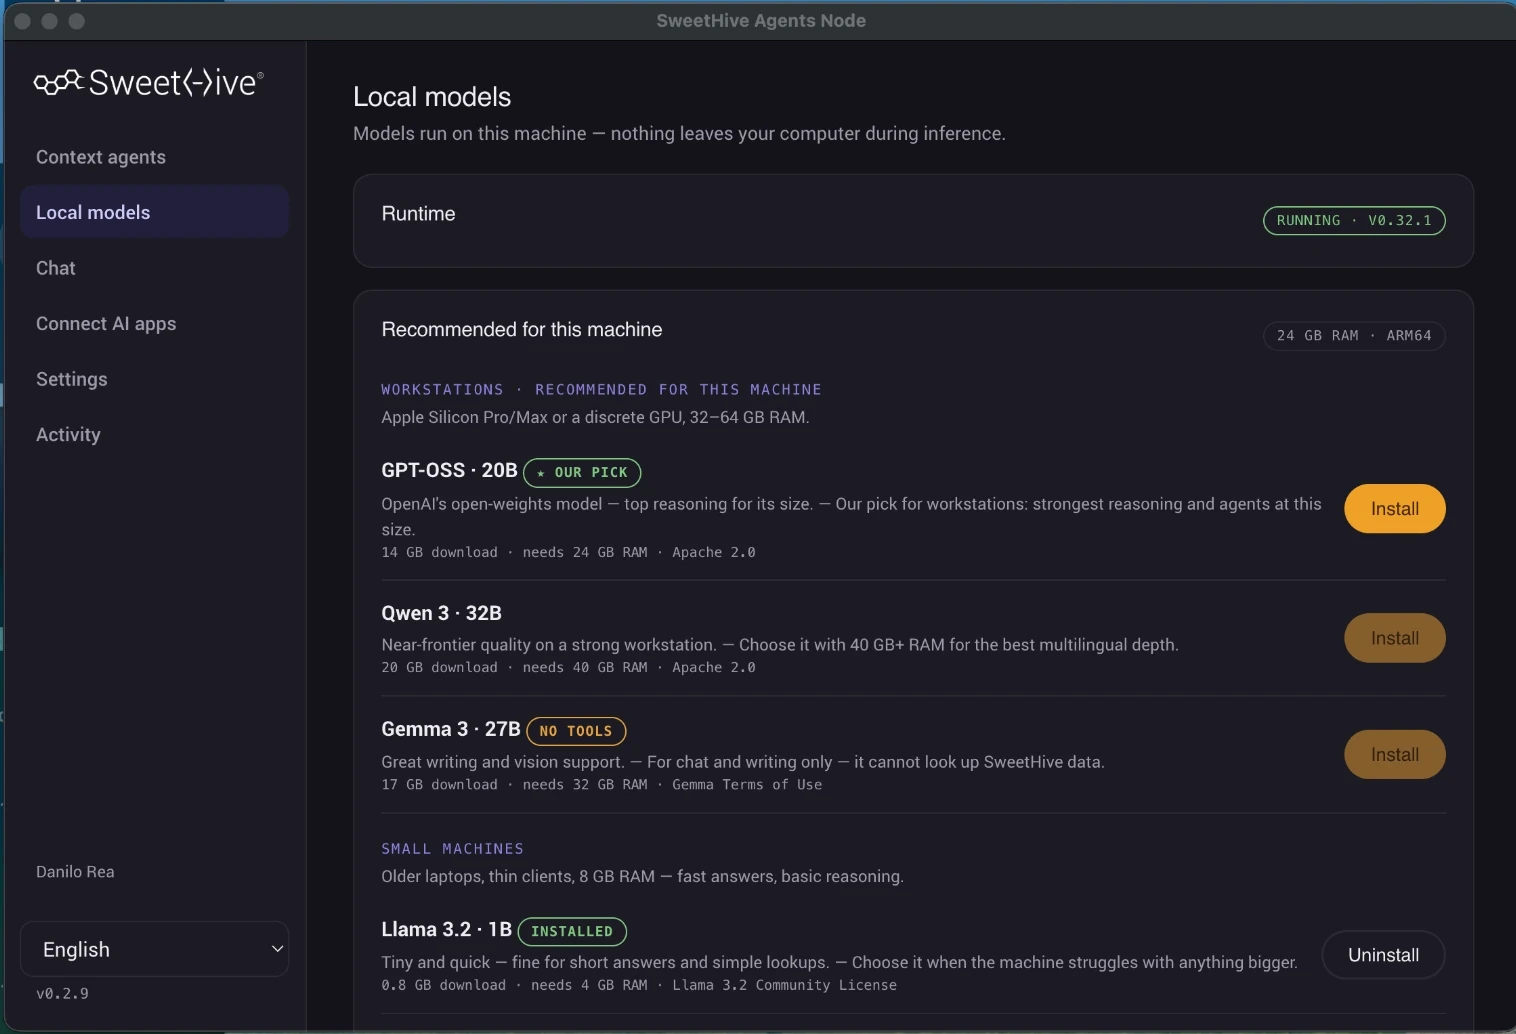
Derselbe Ansatz kommt in SweetHive zum Einsatz, wo kleine Unternehmen lokale Modelle für ihre Agenten wählen und Dateien sowie Prompts auf ihrer eigenen Hardware behalten können.
Drei Fragen für das nächste Budget
- Welche unserer KI-Workloads sind volumenstark und routinemäßig, und was würden sie auf einem Open-Weight-Modell kosten?
- Welche Daten dürfen unsere Rechner, unser Land oder die EU niemals verlassen, und berücksichtigen unsere aktuellen Werkzeuge dies konstruktionsbedingt?
- Wenn wir morgen mehrere Modelle nutzen: Wer entscheidet, welches Modell welche Daten sieht, und wo wird diese Entscheidung festgehalten?
Der Wechsel zu Open-Weight-Modellen ist kein Votum gegen Frontier-Modelle. Er markiert den Beginn eines gemischten Setups, und in einem gemischten Setup liegt der Vorteil bei demjenigen, der das Routing steuert.
Quellen
- Vercel, AI Gateway Production Index, 17. September 2026: vercel.com/blog
- CNBC, zum Anteil chinesischer Modelle am OpenRouter-Datenverkehr, 26. September 2026: cnbc.com
- AI Weekly, Zusammenfassung des Bloomberg-Berichts zu OpenRouter-Daten für US-Unternehmen, 22. Juli 2026: aiweekly.co
- Ramp, AI Index, 9. September 2026: ramp.com/data/ai-index-sept-2026
- Techstrong.ai zur Umfrage von Enterprise Technology Research, September 2026: techstrong.ai
- a16z, Umfrage unter Unternehmens-CIOs, 2026: a16z.com